主题
整理自 JavaGuide:原文。全文搬运仅供个人学习,请勿外传。
Redis 基础
什么是 Redis?
Redis (REmote DIctionary Server)是一个基于 C 语言开发的开源 NoSQL 数据库(BSD 许可)。与传统数据库不同的是,Redis 的数据是保存在内存中的(内存数据库,支持持久化),因此读写速度非常快,被广泛应用于分布式缓存方向。并且,Redis 存储的是 KV 键值对数据。
为了满足不同的业务场景,Redis 内置了多种数据类型实现(比如 String、Hash、Sorted Set、Bitmap、HyperLogLog、GEO)。并且,Redis 还支持事务、持久化、Lua 脚本、发布订阅模型、多种开箱即用的集群方案(Redis Sentinel、Redis Cluster)。
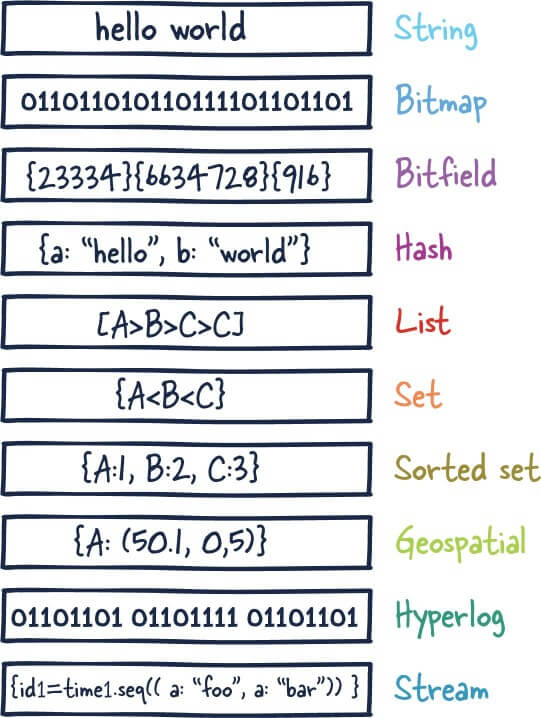
Redis 没有外部依赖,Linux 和 OS X 是 Redis 开发和测试最多的两个操作系统,官方推荐生产环境使用 Linux 部署 Redis。
个人学习的话,你可以自己本机安装 Redis 或者通过 Redis 官网提供的在线 Redis 环境(少部分命令无法使用)来实际体验 Redis。
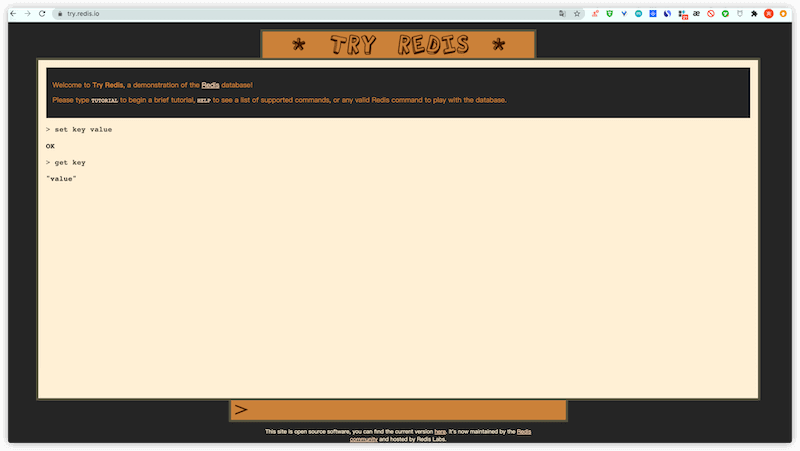
全世界有非常多的网站使用到了 Redis,techstacks.io 专门维护了一个使用 Redis 的热门站点列表,感兴趣的话可以看看。
⭐️Redis 为什么这么快?
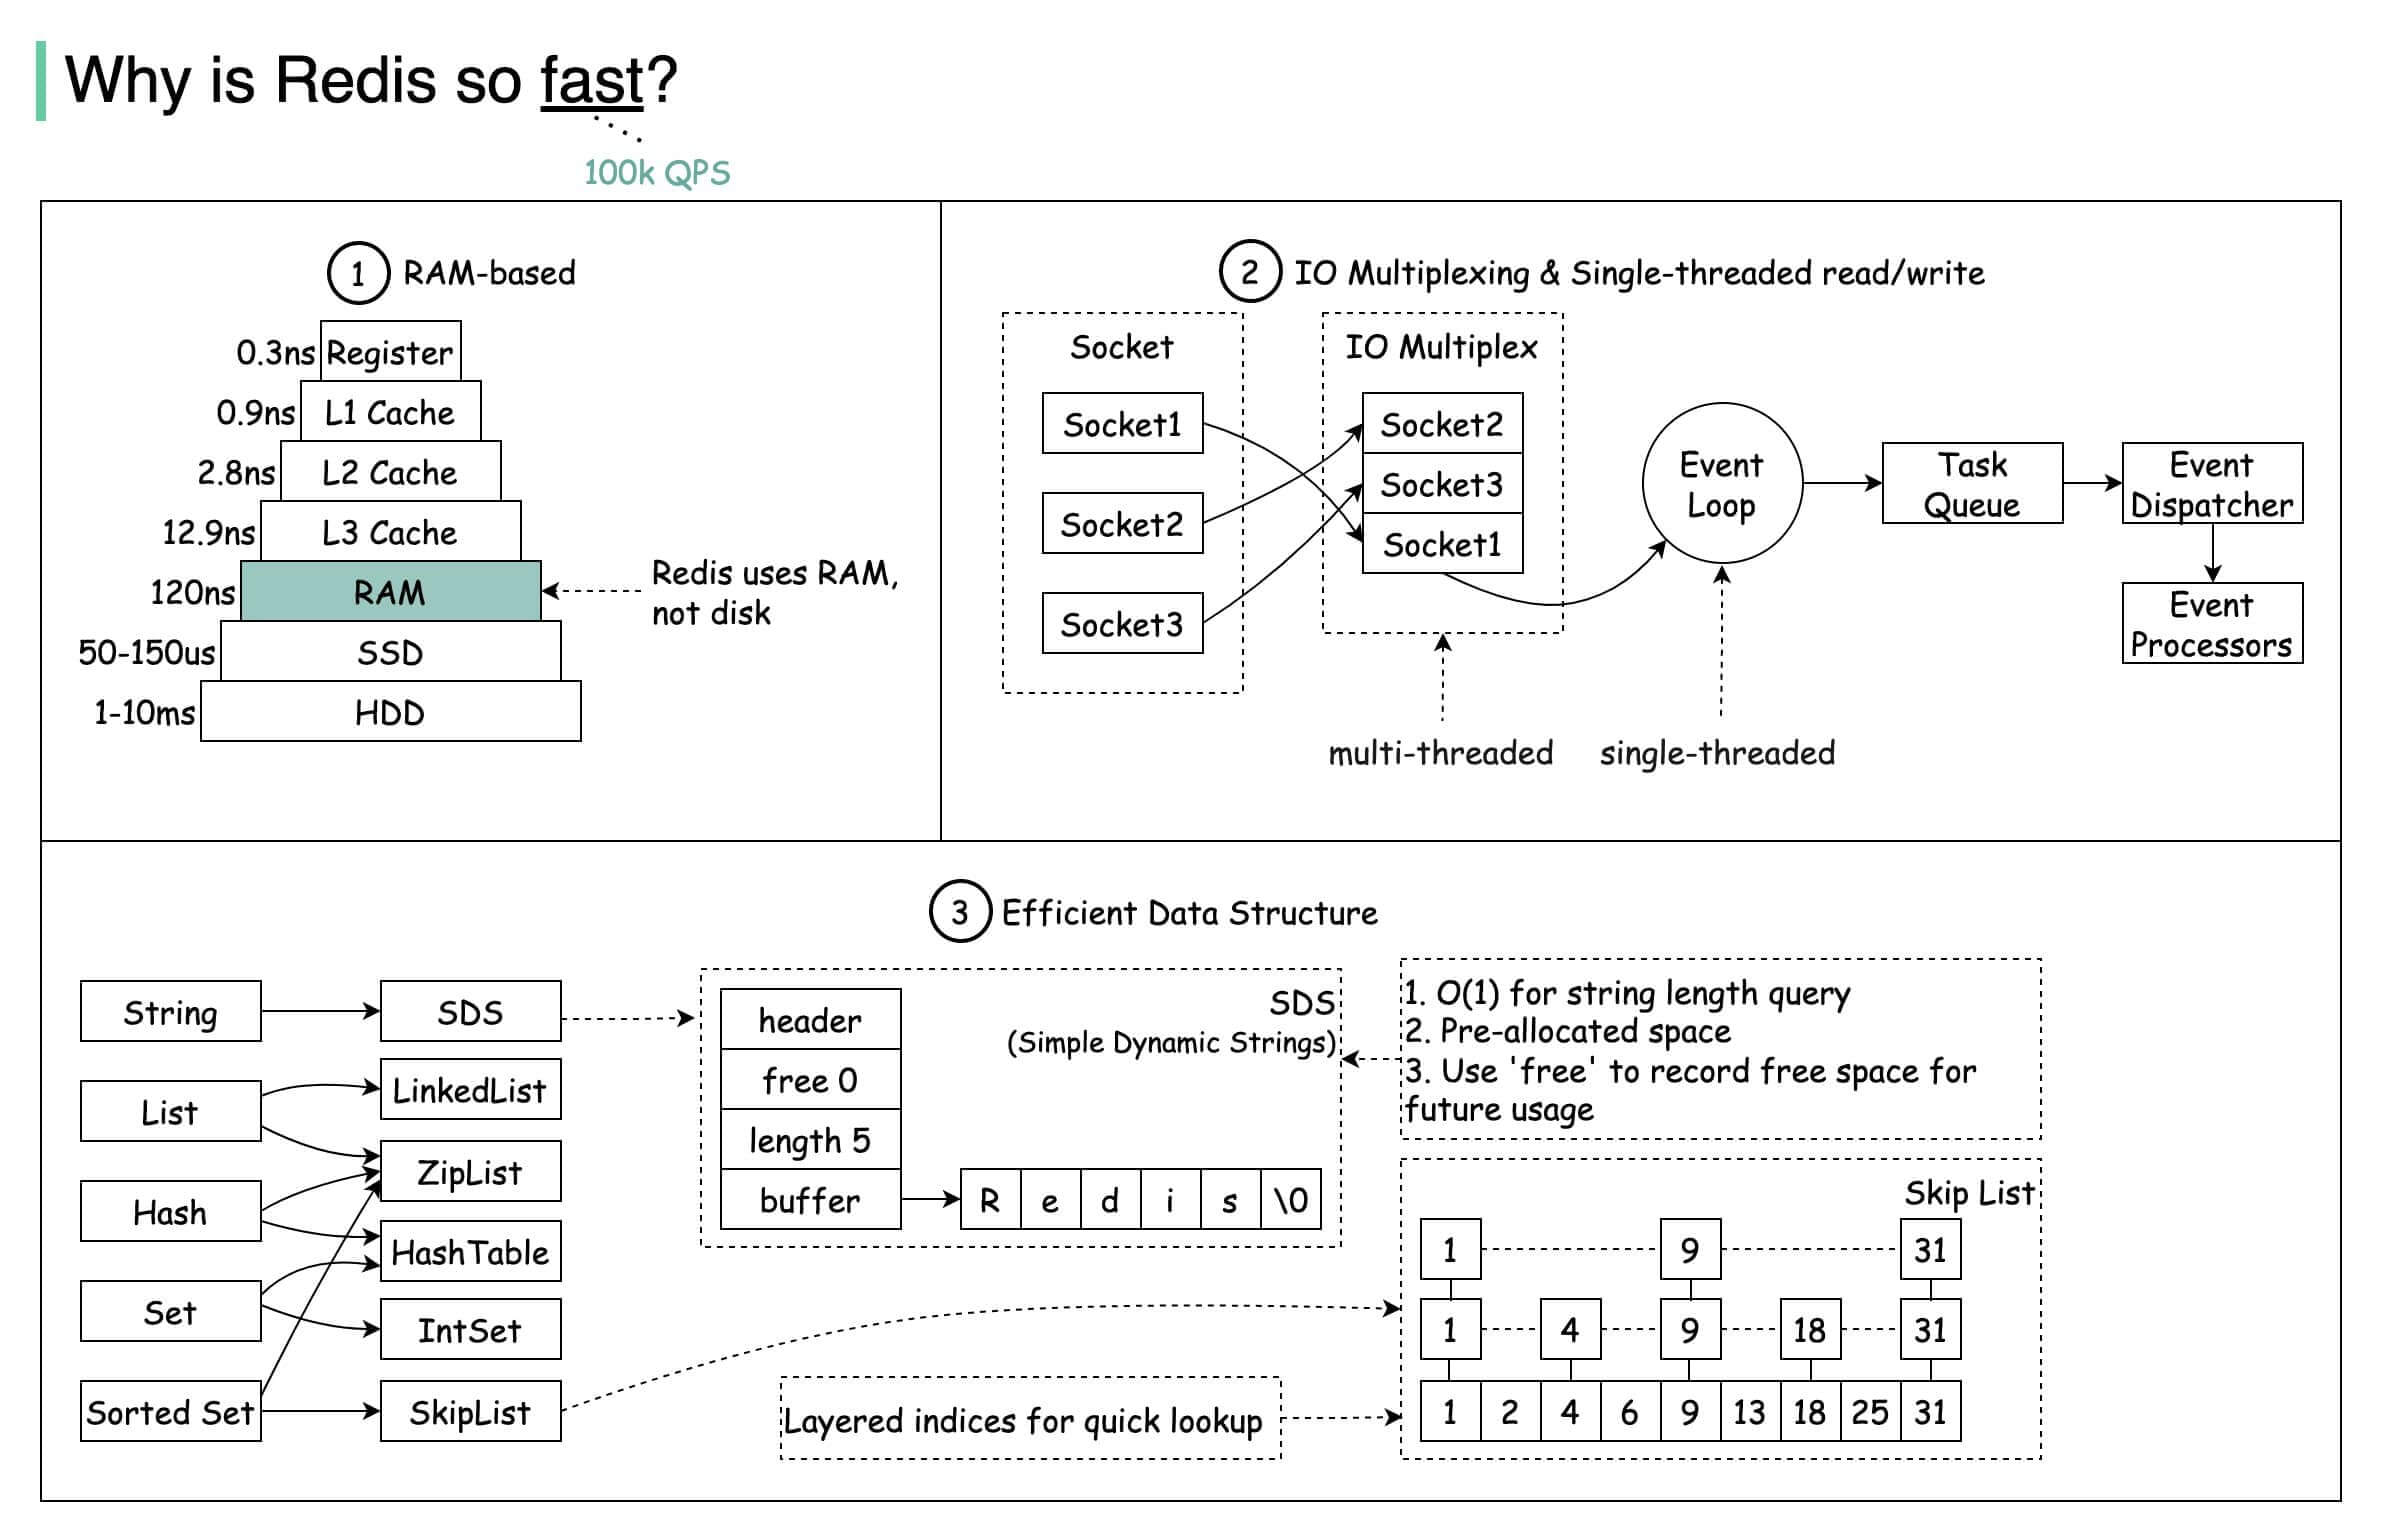
Redis 内部做了非常多的性能优化,比较重要的有下面 4 点:
- 纯内存操作 (Memory-Based Storage) :这是最主要的原因。Redis 数据读写操作都发生在内存中,访问速度是纳秒级别,而传统数据库频繁读写磁盘的速度是毫秒级别,两者相差数个数量级。
- 高效的 I/O 模型 (I/O Multiplexing & Single-Threaded Event Loop) :Redis 使用单线程事件循环配合 I/O 多路复用技术,让单个线程可以同时处理多个网络连接上的 I/O 事件(如读写),避免了多线程模型中的上下文切换和锁竞争问题。虽然是单线程,但结合内存操作的高效性和 I/O 多路复用,使得 Redis 能轻松处理大量并发请求(Redis 线程模型会在后文中详细介绍到)。
- 优化的内部数据结构 (Optimized Data Structures) :Redis 提供多种数据类型(如 String, List, Hash, Set, Sorted Set 等),其内部实现采用高度优化的编码方式(如 ziplist, quicklist, skiplist, hashtable 等)。Redis 会根据数据大小和类型动态选择最合适的内部编码,以在性能和空间效率之间取得最佳平衡。
- 简洁高效的通信协议 (Simple Protocol - RESP) :Redis 使用的是自己设计的 RESP (REdis Serialization Protocol) 协议。这个协议实现简单、解析性能好,并且是二进制安全的。客户端和服务端之间通信的序列化/反序列化开销很小,有助于提升整体的交互速度。
下面这张图片总结的挺不错的,分享一下,出自 Why is Redis so fast?。
那既然都这么快了,为什么不直接用 Redis 当主数据库呢?主要是因为内存成本太高,并且 Redis 提供的数据持久化仍然有数据丢失的风险。
除了 Redis,你还知道其他分布式缓存方案吗?
如果面试中被问到这个问题的话,面试官主要想看看:
- 你在选择 Redis 作为分布式缓存方案时,是否是经过严谨的调研和思考,还是只是因为 Redis 是当前的“热门”技术。
- 你在分布式缓存方向的技术广度。
如果你了解其他方案,并且能解释为什么最终选择了 Redis(更进一步!),这会对你面试表现加分不少!
下面简单聊聊常见的分布式缓存技术选型。
分布式缓存的话,比较老牌同时也是使用的比较多的还是 Memcached 和 Redis。不过,现在基本没有看过还有项目使用 Memcached 来做缓存,都是直接用 Redis。
Memcached 是分布式缓存最开始兴起的那会,比较常用的。后来,随着 Redis 的发展,大家慢慢都转而使用更加强大的 Redis 了。
有一些大厂也开源了类似于 Redis 的分布式高性能 KV 存储数据库,例如,腾讯开源的 Tendis。Tendis 基于知名开源项目 RocksDB 作为存储引擎 ,100% 兼容 Redis 协议和 Redis4.0 所有数据模型。关于 Redis 和 Tendis 的对比,腾讯官方曾经发过一篇文章:Redis vs Tendis:冷热混合存储版架构揭秘,可以简单参考一下。
不过,从 Tendis 这个项目的 Github 提交记录可以看出,Tendis 开源版几乎已经没有被维护更新了,加上其关注度并不高,使用的公司也比较少。因此,不建议你使用 Tendis 来实现分布式缓存。
目前,比较业界认可的 Redis 替代品还是下面这两个开源分布式缓存(都是通过碰瓷 Redis 火的):
- Dragonfly:一种针对现代应用程序负荷需求而构建的内存数据库,完全兼容 Redis 和 Memcached 的 API,迁移时无需修改任何代码,号称全世界最快的内存数据库。
- KeyDB:Redis 的一个高性能分支,专注于多线程、内存效率和高吞吐量。
不过,个人还是建议分布式缓存首选 Redis,毕竟经过了这么多年的考验,生态非常优秀,资料也很全面!
PS:篇幅问题,我这并没有对上面提到的分布式缓存选型做详细介绍和对比,感兴趣的话,可以自行研究一下。
说一下 Redis 和 Memcached 的区别和共同点
现在公司一般都是用 Redis 来实现缓存,而且 Redis 自身也越来越强大了!不过,了解 Redis 和 Memcached 的区别和共同点,有助于我们在做相应的技术选型的时候,能够做到有理有据!
共同点:
- 都是基于内存的数据库,一般都用来当做缓存使用。
- 都有过期策略。
- 两者的性能都非常高。
区别:
- 数据类型:Redis 支持更丰富的数据类型(支持更复杂的应用场景)。Redis 不仅仅支持简单的 k/v 类型的数据,同时还提供 list、set、zset、hash 等数据结构的存储;而 Memcached 只支持最简单的 k/v 数据类型。
- 数据持久化:Redis 支持数据的持久化,可以将内存中的数据保持在磁盘中,重启的时候可以再次加载进行使用;而 Memcached 把数据全部存在内存之中。也就是说,Redis 有灾难恢复机制,而 Memcached 没有。
- 集群模式支持:Memcached 没有原生的集群模式,需要依靠客户端来实现往集群中分片写入数据;而 Redis 自 3.0 版本起是原生支持集群模式的。
- 线程模型:Memcached 是多线程、非阻塞 IO 复用的网络模型;而 Redis 使用单线程的多路 IO 复用模型(Redis 6.0 针对网络数据的读写引入了多线程)。
- 特性支持:Redis 支持发布订阅模型、Lua 脚本、事务等功能,而 Memcached 不支持。并且,Redis 支持更多的编程语言。
- 过期数据删除:Memcached 过期数据的删除策略只用了惰性删除,而 Redis 同时使用了惰性删除与定期删除。
相信看了上面的对比之后,我们已经没有什么理由可以选择使用 Memcached 来作为自己项目的分布式缓存了。
⭐️为什么要用 Redis?
1、访问速度更快
传统数据库数据保存在磁盘,而 Redis 基于内存,内存的访问速度比磁盘快很多。引入 Redis 之后,我们可以把一些高频访问的数据放到 Redis 中,这样下次就可以直接从内存中读取,速度可以提升几十倍甚至上百倍。
2、高并发
一般像 MySQL 这类的数据库的 QPS 大概都在 4k 左右(4 核 8g),但是使用 Redis 缓存之后很容易达到 5w+,甚至能达到 10w+(就单机 Redis 的情况,Redis 集群的话会更高)。
QPS(Query Per Second):服务器每秒可以执行的查询次数;
由此可见,直接操作缓存能够承受的数据库请求数量是远远大于直接访问数据库的,所以我们可以考虑把数据库中的部分数据转移到缓存中去,这样用户的一部分请求会直接到缓存这里而不用经过数据库。进而,我们也就提高了系统整体的并发。
3、功能全面
Redis 除了可以用作缓存之外,还可以用于分布式锁、限流、消息队列、延时队列等场景,功能强大!
⭐️为什么用 Redis 而不用本地缓存呢?
| 特性 | 本地缓存 | Redis |
|---|---|---|
| 数据一致性 | 多服务器部署时存在数据不一致问题 | 数据一致 |
| 内存限制 | 受限于单台服务器内存 | 独立部署,内存空间更大 |
| 数据丢失风险 | 服务器宕机数据丢失 | 可持久化,数据不易丢失 |
| 管理维护 | 分散,管理不便 | 集中管理,提供丰富的管理工具 |
| 功能丰富性 | 功能有限,通常只提供简单的键值对存储 | 功能丰富,支持多种数据结构和功能 |
关于本地缓存、分布式缓存和多级缓存的详细介绍,可以看我写的这篇文章:[缓存基础常见面试题总结]。
常见的缓存读写策略有哪些?
关于常见的缓存读写策略的详细介绍,可以看我写的这篇文章:3 种常用的缓存读写策略详解。
什么是 Redis Module?有什么用?
Redis 从 4.0 版本开始,支持通过 Module 来扩展其功能以满足特殊的需求。这些 Module 以动态链接库(so 文件)的形式被加载到 Redis 中,这是一种非常灵活的动态扩展功能的实现方式,值得借鉴学习!
我们每个人都可以基于 Redis 去定制化开发自己的 Module,比如实现搜索引擎功能、自定义分布式锁和分布式限流。
目前,被 Redis 官方推荐的 Module 有:
- RediSearch:用于实现搜索引擎的模块。
- RedisJSON:用于处理 JSON 数据的模块。
- RedisGraph:用于实现图形数据库的模块。
- RedisTimeSeries:用于处理时间序列数据的模块。
- RedisBloom:用于实现布隆过滤器的模块。
- RedisAI:用于执行深度学习/机器学习模型并管理其数据的模块。
- RedisCell:用于实现分布式限流的模块。
- ……
关于 Redis 模块的详细介绍,可以查看官方文档:https://redis.io/modules。
⭐️Redis 应用
Redis 除了做缓存,还能做什么?
- 分布式锁:通过 Redis 来做分布式锁是一种比较常见的方式。通常情况下,我们都是基于 Redisson 来实现分布式锁。关于 Redis 实现分布式锁的详细介绍,可以看我写的这篇文章:分布式锁详解。
- 限流:一般是通过 Redis + Lua 脚本的方式来实现限流。如果不想自己写 Lua 脚本的话,也可以直接利用 Redisson 中的
RRateLimiter来实现分布式限流,其底层实现就是基于 Lua 代码+令牌桶算法。 - 消息队列:Redis 自带的 List 数据结构可以作为一个简单的队列使用。Redis 5.0 中增加的 Stream 类型的数据结构更加适合用来做消息队列。它比较类似于 Kafka,有主题和消费组的概念,支持消息持久化以及 ACK 机制。
- 延时队列:Redisson 内置了延时队列(基于 Sorted Set 实现的)。
- 分布式 Session:利用 String 或者 Hash 数据类型保存 Session 数据,所有的服务器都可以访问。
- 复杂业务场景:通过 Redis 以及 Redis 扩展(比如 Redisson)提供的数据结构,我们可以很方便地完成很多复杂的业务场景,比如通过 Bitmap 统计活跃用户、通过 Sorted Set 维护排行榜、通过 HyperLogLog 统计网站 UV 和 PV。
- ……
如何基于 Redis 实现分布式锁?
关于 Redis 实现分布式锁的详细介绍,可以看我写的这篇文章:分布式锁详解。
Redis 可以做消息队列么?怎么实现?
先说结论:
- 如果业务简单、量小、追求极致性能,且能容忍极小概率的数据丢失,使用 Redis Stream 是最优解,因为它省去了部署维护 MQ 的成本,可以复用现有的 Redis 组件(大部分需要用到 MQ 的项目,通常都会需要 Redis)。
- 如果是金融级业务、海量数据、需要严格保证不丢消息,必须选择 Kafka、RabbitMQ 等更成熟的 MQ。
这个问题还是挺重要,技术选型也能用上,我专门写了一篇文章详细介绍和分析,推荐时间充足的同学抽空认真看几遍,收藏一下:Redis 能做消息队列吗?怎么实现?。
如何基于 Redis 实现延时任务?
类似的问题:
- 订单在 10 分钟后未支付就失效,如何用 Redis 实现?
- 红包 24 小时未被查收自动退还,如何用 Redis 实现?
基于 Redis 实现延时任务的功能无非就下面两种方案:
- Redis 过期事件监听。
- Redisson 内置的延时队列。
Redis 过期事件监听存在时效性较差、丢消息、多服务实例下消息重复消费等问题,不被推荐使用。
Redisson 内置的延时队列具备下面这些优势:
- 减少了丢消息的可能:DelayedQueue 中的消息会被持久化,即使 Redis 宕机了,根据持久化机制,也只可能丢失一点消息,影响不大。当然了,你也可以使用扫描数据库的方法作为补偿机制。
- 消息不存在重复消费问题:每个客户端都是从同一个目标队列中获取任务的,不存在重复消费的问题。
关于 Redis 实现延时任务的详细介绍,可以看我写的这篇文章:如何基于 Redis 实现延时任务?。
⭐️Redis 数据类型
关于 Redis 5 种基础数据类型和 3 种特殊数据类型的详细介绍请看下面这两篇文章以及 Redis 官方文档:
Redis 常用的数据类型有哪些?
Redis 中比较常见的数据类型有下面这些:
- 5 种基础数据类型:String(字符串)、List(列表)、Set(集合)、Hash(散列)、Zset(有序集合)。
- 3 种特殊数据类型:HyperLogLog(基数统计)、Bitmap (位图)、Geospatial (地理位置)。
除了上面提到的之外,还有一些其他的比如 Bloom filter(布隆过滤器)、Bitfield(位域)。
String 的应用场景有哪些?
String 是 Redis 中最简单同时也是最常用的一个数据类型。它是一种二进制安全的数据类型,可以用来存储任何类型的数据比如字符串、整数、浮点数、图片(图片的 base64 编码或者解码或者图片的路径)、序列化后的对象。
String 的常见应用场景如下:
- 常规数据(比如 Session、Token、序列化后的对象、图片的路径)的缓存;
- 计数比如用户单位时间的请求数(简单限流可以用到)、页面单位时间的访问数;
- 分布式锁(利用
SETNX key value命令可以实现一个最简易的分布式锁); - ……
关于 String 的详细介绍请看这篇文章:Redis 5 种基本数据类型详解。
String 还是 Hash 存储对象数据更好呢?
简单对比一下二者:
- 对象存储方式:String 存储的是序列化后的对象数据,存放的是整个对象,操作简单直接。Hash 是对对象的每个字段单独存储,可以获取部分字段的信息,也可以修改或者添加部分字段,节省网络流量。如果对象中某些字段需要经常变动或者经常需要单独查询对象中的个别字段信息,Hash 就非常适合。
- 内存消耗:Hash 通常比 String 更节省内存,特别是在字段较多且字段长度较短时。Redis 对小型 Hash 进行优化(如使用 ziplist 存储),进一步降低内存占用。
- 复杂对象存储:String 在处理多层嵌套或复杂结构的对象时更方便,因为无需处理每个字段的独立存储和操作。
- 性能:String 的操作通常具有 O(1) 的时间复杂度,因为它存储的是整个对象,操作简单直接,整体读写的性能较好。Hash 由于需要处理多个字段的增删改查操作,在字段较多且经常变动的情况下,可能会带来额外的性能开销。
总结:
- 在绝大多数情况下,String 更适合存储对象数据,尤其是当对象结构简单且整体读写是主要操作时。
- 如果你需要频繁操作对象的部分字段或节省内存,Hash 可能是更好的选择。
String 的底层实现是什么?
Redis 是基于 C 语言编写的,但 Redis 的 String 类型的底层实现并不是 C 语言中的字符串(即以空字符 \0 结尾的字符数组),而是自己编写了 SDS(Simple Dynamic String,简单动态字符串)来作为底层实现。
SDS 最早是 Redis 作者为日常 C 语言开发而设计的 C 字符串,后来被应用到了 Redis 上,并经过了大量的修改完善以适合高性能操作。
Redis7.0 的 SDS 的部分源码如下(https://github.com/redis/redis/blob/7.0/src/sds.h):
c
/* Note: sdshdr5 is never used, we just access the flags byte directly.
 * However is here to document the layout of type 5 SDS strings. */
struct __attribute__ ((__packed__)) sdshdr5 {
    unsigned char flags; /* 3 lsb of type, and 5 msb of string length */
    char buf[];
};
struct __attribute__ ((__packed__)) sdshdr8 {
    uint8_t len; /* used */
    uint8_t alloc; /* excluding the header and null terminator */
    unsigned char flags; /* 3 lsb of type, 5 unused bits */
    char buf[];
};
struct __attribute__ ((__packed__)) sdshdr16 {
    uint16_t len; /* used */
    uint16_t alloc; /* excluding the header and null terminator */
    unsigned char flags; /* 3 lsb of type, 5 unused bits */
    char buf[];
};
struct __attribute__ ((__packed__)) sdshdr32 {
    uint32_t len; /* used */
    uint32_t alloc; /* excluding the header and null terminator */
    unsigned char flags; /* 3 lsb of type, 5 unused bits */
    char buf[];
};
struct __attribute__ ((__packed__)) sdshdr64 {
    uint64_t len; /* used */
    uint64_t alloc; /* excluding the header and null terminator */
    unsigned char flags; /* 3 lsb of type, 5 unused bits */
    char buf[];
};通过源码可以看出,SDS 共有五种实现方式:SDS_TYPE_5(并未用到)、SDS_TYPE_8、SDS_TYPE_16、SDS_TYPE_32、SDS_TYPE_64,其中只有后四种实际用到。Redis 会根据初始化的长度决定使用哪种类型,从而减少内存的使用。
| 类型 | 字节 | 位 |
|---|---|---|
| sdshdr5 | < 1 | <8 |
| sdshdr8 | 1 | 8 |
| sdshdr16 | 2 | 16 |
| sdshdr32 | 4 | 32 |
| sdshdr64 | 8 | 64 |
对于后四种实现都包含了下面这 4 个属性:
len:字符串的长度也就是已经使用的字节数。alloc:总共可用的字符空间大小,alloc-len 就是 SDS 剩余的空间大小。buf[]:实际存储字符串的数组。flags:低三位保存类型标志。
SDS 相比于 C 语言中的字符串有如下提升:
- 可以避免缓冲区溢出:C 语言中的字符串被修改(比如拼接)时,一旦没有分配足够长度的内存空间,就会造成缓冲区溢出。SDS 被修改时,会先根据 len 属性检查空间大小是否满足要求,如果不满足,则先扩展至所需大小再进行修改操作。
- 获取字符串长度的复杂度较低:C 语言中的字符串的长度通常是经过遍历计数来实现的,时间复杂度为 O(n)。SDS 的长度获取直接读取 len 属性即可,时间复杂度为 O(1)。
- 减少内存分配次数:为了避免修改(增加/减少)字符串时,每次都需要重新分配内存(C 语言的字符串是这样的),SDS 实现了空间预分配和惰性空间释放两种优化策略。当 SDS 需要增加字符串时,Redis 会为 SDS 分配好内存,并且根据特定的算法分配多余的内存,这样可以减少连续执行字符串增长操作所需的内存重分配次数。当 SDS 需要减少字符串时,这部分内存不会立即被回收,会被记录下来,等待后续使用(支持手动释放,有对应的 API)。
- 二进制安全:C 语言中的字符串以空字符
\0作为字符串结束的标识,这存在一些问题,像一些二进制文件(比如图片、视频、音频)就可能包括空字符,C 字符串无法正确保存。SDS 使用 len 属性判断字符串是否结束,不存在这个问题。
🤐 多提一嘴,很多文章里 SDS 的定义是下面这样的:
c
struct sdshdr {
    unsigned int len;
    unsigned int free;
    char buf[];
};这个也没错,Redis 3.2 之前就是这样定义的。后来,由于这种方式的定义存在问题,len 和 free 的定义用了 4 个字节,造成了浪费。Redis 3.2 之后,Redis 改进了 SDS 的定义,将其划分为了现在的 5 种类型。
购物车信息用 String 还是 Hash 存储更好呢?
由于购物车中的商品频繁修改和变动,购物车信息建议使用 Hash 存储:
- 用户 id 为 key
- 商品 id 为 field,商品数量为 value
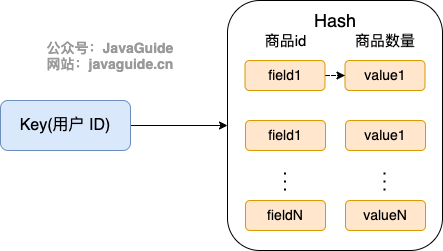
那用户购物车信息的维护具体应该怎么操作呢?
- 用户添加商品就是往 Hash 里面增加新的 field 与 value;
- 查询购物车信息就是遍历对应的 Hash;
- 更改商品数量直接修改对应的 value 值(直接 set 或者做运算皆可);
- 删除商品就是删除 Hash 中对应的 field;
- 清空购物车直接删除对应的 key 即可。
这里只是以业务比较简单的购物车场景举例,实际电商场景下,field 只保存一个商品 id 是没办法满足需求的。
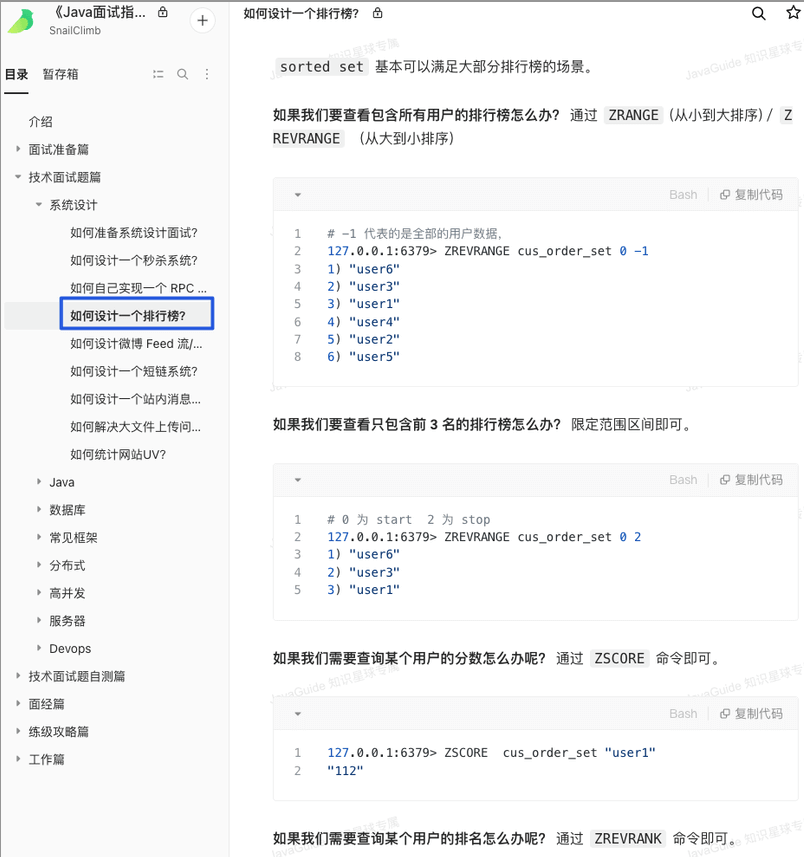
使用 Redis 实现一个排行榜怎么做?
Redis 中有一个叫做 Sorted Set(有序集合)的数据类型经常被用在各种排行榜的场景,比如直播间送礼物的排行榜、朋友圈的微信步数排行榜、王者荣耀中的段位排行榜、话题热度排行榜等等。
相关的一些 Redis 命令:ZRANGE(从小到大排序)、ZREVRANGE(从大到小排序)、ZREVRANK(指定元素排名)。

《Java 面试指北》 的「技术面试题篇」就有一篇文章详细介绍如何使用 Sorted Set 来设计制作一个排行榜,感兴趣的小伙伴可以看看。
Redis 的有序集合底层为什么要用跳表,而不用平衡树、红黑树或者 B+ 树?
这道面试题很多大厂比较喜欢问,难度还是有点大的。
- 平衡树 vs 跳表:平衡树的插入、删除和查询的时间复杂度和跳表一样都是 **O(log n)**。对于范围查询来说,平衡树也可以通过中序遍历的方式达到和跳表一样的效果。但是它的每一次插入或者删除操作都需要保证整颗树左右节点的绝对平衡,只要不平衡就要通过旋转操作来保持平衡,这个过程是比较耗时的。跳表诞生的初衷就是为了克服平衡树的一些缺点。跳表使用概率平衡而不是严格强制的平衡,因此,跳表中的插入和删除算法比平衡树的等效算法简单得多,速度也快得多。
- 红黑树 vs 跳表:相比较于红黑树来说,跳表的实现也更简单一些,不需要通过旋转和染色(红黑变换)来保证黑平衡。并且,按照区间来查找数据这个操作,红黑树的效率没有跳表高。
- B+ 树 vs 跳表:B+ 树更适合作为数据库和文件系统中常用的索引结构之一,它的核心思想是通过可能少的 IO 定位到尽可能多的索引来获得查询数据。对于 Redis 这种内存数据库来说,它对这些并不感冒,因为 Redis 作为内存数据库它不可能存储大量的数据,所以对于索引不需要通过 B+ 树这种方式进行维护,只需按照概率进行随机维护即可,节约内存。而且使用跳表实现 zset 时相较前者来说更简单一些,在进行插入时只需通过索引将数据插入到链表中合适的位置再随机维护一定高度的索引即可,也不需要像 B+ 树那样插入时发现失衡时还需要对节点分裂与合并。
另外,我还单独写了一篇文章从有序集合的基本使用到跳表的源码分析和实现,让你会对 Redis 的有序集合底层实现的跳表有着更深刻的理解和掌握:Redis 为什么用跳表实现有序集合。如果只想先过一遍跳表的基础结构、复杂度和范围查询,可以看 跳表面试题总结。
Set 的应用场景是什么?
Redis 中 Set 是一种无序集合,集合中的元素没有先后顺序但都唯一,有点类似于 Java 中的 HashSet 。
Set 的常见应用场景如下:
- 存放的数据不能重复的场景:网站 UV 统计(数据量巨大的场景还是
HyperLogLog更适合一些)、文章点赞、动态点赞等等。 - 需要获取多个数据源交集、并集和差集的场景:共同好友(交集)、共同粉丝(交集)、共同关注(交集)、好友推荐(差集)、音乐推荐(差集)、订阅号推荐(差集+交集)等等。
- 需要随机获取数据源中的元素的场景:抽奖系统、随机点名等等。
使用 Set 实现抽奖系统怎么做?
如果想要使用 Set 实现一个简单的抽奖系统的话,直接使用下面这几个命令就可以了:
SADD key member1 member2 ...:向指定集合添加一个或多个元素。SPOP key count:随机移除并获取指定集合中一个或多个元素,适合不允许重复中奖的场景。SRANDMEMBER key count:随机获取指定集合中指定数量的元素,适合允许重复中奖的场景。
使用 Bitmap 统计活跃用户怎么做?
Bitmap 存储的是连续的二进制数字(0 和 1),通过 Bitmap,只需要一个 bit 位来表示某个元素对应的值或者状态,key 就是对应元素本身。我们知道 8 个 bit 可以组成一个 byte,所以 Bitmap 本身会极大的节省储存空间。
你可以将 Bitmap 看作是一个存储二进制数字(0 和 1)的数组,数组中每个元素的下标叫做 offset(偏移量)。
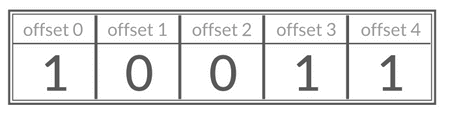
如果想要使用 Bitmap 统计活跃用户的话,可以使用日期(精确到天)作为 key,然后用户 ID 为 offset,如果当日活跃过就设置为 1。
初始化数据:
bash
> SETBIT 20210308 1 1
(integer) 0
> SETBIT 20210308 2 1
(integer) 0
> SETBIT 20210309 1 1
(integer) 0统计 20210308~20210309 总活跃用户数:
bash
> BITOP and desk1 20210308 20210309
(integer) 1
> BITCOUNT desk1
(integer) 1统计 20210308~20210309 在线活跃用户数:
bash
> BITOP or desk2 20210308 20210309
(integer) 1
> BITCOUNT desk2
(integer) 2HyperLogLog 适合什么场景?
HyperLogLog (HLL) 是一种非常巧妙的概率性数据结构,它专门解决一类非常棘手的大数据问题:在海量数据中,用极小的内存,估算一个集合中不重复元素的数量,也就是我们常说的基数(Cardinality)
HLL 做的最核心的权衡,就是用一点点精确度的损失,来换取巨大的内存空间节省。它给出的不是一个 100%精确的数字,而是一个带有很小标准误差(Redis 中默认是 0.81%)的近似值。
基于这个核心权衡,HyperLogLog 最适合以下特征的场景:
- 数据量巨大,内存敏感: 这是 HLL 的主战场。比如,要统计一个亿级日活 App 的每日独立访客数。如果用传统的 Set 来存储用户 ID,一个 ID 占几十个字节,上亿个 ID 可能需要几个 GB 甚至几十 GB 的内存,这在很多场景下是不可接受的。而 HLL,在 Redis 中只需要固定的 12KB 内存,就能处理天文数字级别的基数,这是一个颠覆性的优势。
- 对结果的精确度要求不是 100%: 这是使用 HLL 的前提。比如,产品经理想知道一个热门帖子的 UV(独立访客数)是大约 1000 万还是 1010 万,这个细微的差别通常不影响商业决策。但如果场景是统计一个交易系统的准确交易笔数,那 HLL 就完全不适用,因为金融场景要求 100%的精确。
所以,HyperLogLog 具体的应用场景就非常清晰了:
- 网站/App 的 UV(Unique Visitor)统计: 比如统计首页每天有多少个不同的 IP 或用户 ID 访问过。
- 搜索引擎关键词统计: 统计每天有多少个不同的用户搜索了某个关键词。
- 社交网络互动统计: 比如统计一条微博被多少个不同的用户转发过。
在这些场景下,我们关心的是数量级和趋势,而不是个位数的差异。
最后,Redis 的实现还非常智能,它内部会根据基数的大小,在稀疏矩阵(占用空间更小)和稠密矩阵(固定的 12KB)之间自动切换,进一步优化了内存使用。总而言之,当您需要对海量数据进行去重计数,并且可以接受微小误差时,HyperLogLog 就是不二之选。
使用 HyperLogLog 统计页面 UV 怎么做?
使用 HyperLogLog 统计页面 UV 主要需要用到下面这两个命令:
PFADD key element1 element2 ...:添加一个或多个元素到 HyperLogLog 中。PFCOUNT key1 key2:获取一个或者多个 HyperLogLog 的唯一计数。
1、将访问指定页面的每个用户 ID 添加到 HyperLogLog 中。
bash
PFADD PAGE_1:UV USER1 USER2 ...... USERn2、统计指定页面的 UV。
bash
PFCOUNT PAGE_1:UV如果我想判断一个元素是否不在海量元素集合中,用什么数据类型?
这是布隆过滤器的经典应用场景。布隆过滤器可以告诉你一个元素一定不存在或者可能存在,它也有极高的空间效率和一定的误判率,但绝不会漏报。也就是说,布隆过滤器说某个元素存在,小概率会误判。布隆过滤器说某个元素不在,那么这个元素一定不在。
Bloom Filter 的简单原理图如下:
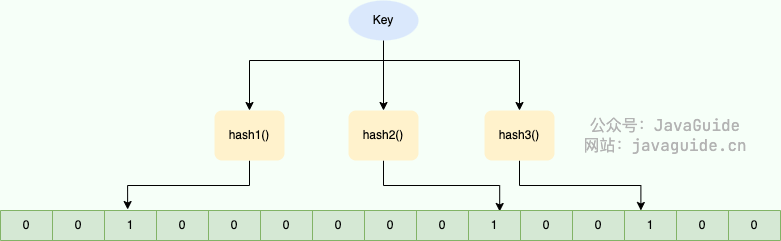
当字符串存储要加入到布隆过滤器中时,该字符串首先由多个哈希函数生成不同的哈希值,然后将对应的位数组的下标设置为 1(当位数组初始化时,所有位置均为 0)。当第二次存储相同字符串时,因为先前的对应位置已设置为 1,所以很容易知道此值已经存在(去重非常方便)。
如果我们需要判断某个字符串是否在布隆过滤器中时,只需要对给定字符串再次进行相同的哈希计算,得到值之后判断位数组中的每个元素是否都为 1,如果值都为 1,那么说明这个值在布隆过滤器中,如果存在一个值不为 1,说明该元素不在布隆过滤器中。
关于布隆过滤器的误判、删除困难、Guava 和 RedisBloom 使用,可以继续看 布隆过滤器详解。
⭐️Redis 持久化机制(重要)
Redis 持久化机制(RDB 持久化、AOF 持久化、RDB 和 AOF 的混合持久化)相关的问题比较多,也比较重要,于是我单独抽了一篇文章来总结 Redis 持久化机制相关的知识点和问题:Redis 持久化机制详解。
⭐️Redis 线程模型(重要)
对于读写命令来说,Redis 一直是单线程模型。不过,在 Redis 4.0 版本之后引入了多线程来执行一些大键值对的异步删除操作,Redis 6.0 版本之后引入了多线程来处理网络请求(提高网络 IO 读写性能)。
Redis 单线程模型了解吗?
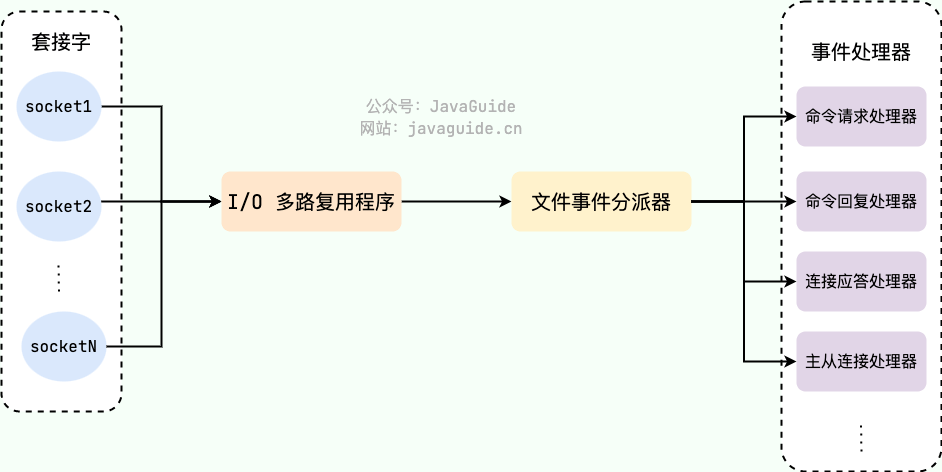
Redis 基于 Reactor 模式设计开发了一套高效的事件处理模型(Netty 的线程模型也基于 Reactor 模式,Reactor 模式不愧是高性能 IO 的基石),这套事件处理模型对应的是 Redis 中的文件事件处理器(file event handler)。由于文件事件处理器(file event handler)是单线程方式运行的,所以我们一般都说 Redis 是单线程模型。
《Redis 设计与实现》有一段话是这样介绍文件事件处理器的,我觉得写得挺不错。
Redis 基于 Reactor 模式开发了自己的网络事件处理器:这个处理器被称为文件事件处理器(file event handler)。
- 文件事件处理器使用 I/O 多路复用(multiplexing)程序来同时监听多个套接字,并根据套接字目前执行的任务来为套接字关联不同的事件处理器。
- 当被监听的套接字准备好执行连接应答(accept)、读取(read)、写入(write)、关 闭(close)等操作时,与操作相对应的文件事件就会产生,这时文件事件处理器就会调用套接字之前关联好的事件处理器来处理这些事件。
虽然文件事件处理器以单线程方式运行,但通过使用 I/O 多路复用程序来监听多个套接字,文件事件处理器既实现了高性能的网络通信模型,又可以很好地与 Redis 服务器中其他同样以单线程方式运行的模块进行对接,这保持了 Redis 内部单线程设计的简单性。
既然是单线程,那怎么监听大量的客户端连接呢?
Redis 通过 IO 多路复用程序 来监听来自客户端的大量连接(或者说是监听多个 socket),它会将感兴趣的事件及类型(读、写)注册到内核中并监听每个事件是否发生。
这样的好处非常明显:I/O 多路复用技术的使用让 Redis 不需要额外创建多余的线程来监听客户端的大量连接,降低了资源的消耗(和 NIO 中的 Selector 组件很像)。
文件事件处理器(file event handler)主要是包含 4 个部分:
- 多个 socket(客户端连接)
- IO 多路复用程序(支持多个客户端连接的关键)
- 文件事件分派器(将 socket 关联到相应的事件处理器)
- 事件处理器(连接应答处理器、命令请求处理器、命令回复处理器)
Redis6.0 之前为什么不使用多线程?
虽然说 Redis 是单线程模型,但实际上,Redis 在 4.0 之后的版本中就已经加入了对多线程的支持。
不过,Redis 4.0 增加的多线程主要是针对一些大键值对的删除操作的命令,使用这些命令就会使用主线程之外的其他线程来“异步处理”,从而减少对主线程的影响。
为此,Redis 4.0 之后新增了几个异步命令:
UNLINK:可以看作是DEL命令的异步版本。FLUSHALL ASYNC:用于清空所有数据库的所有键,不限于当前SELECT的数据库。FLUSHDB ASYNC:用于清空当前SELECT数据库中的所有键。
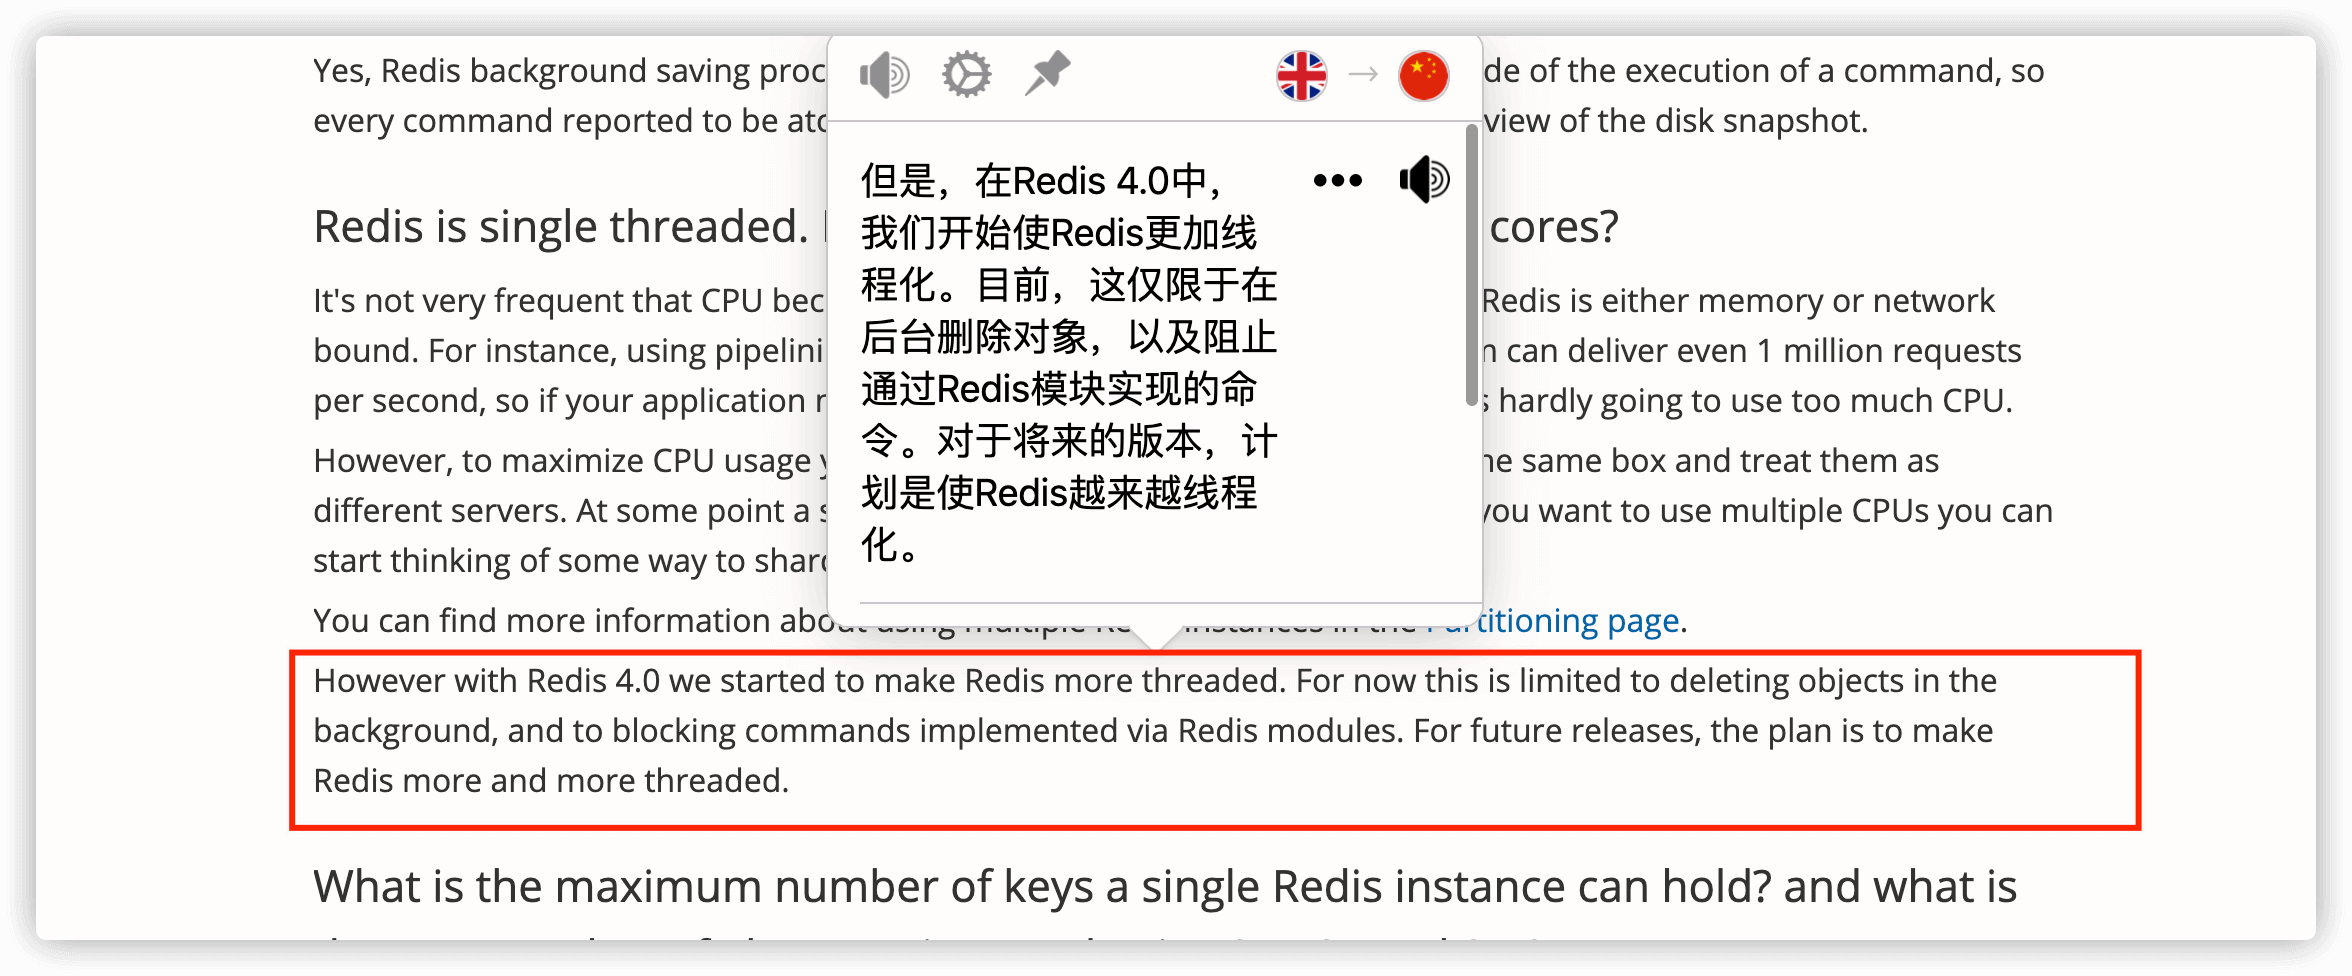
总的来说,直到 Redis 6.0 之前,Redis 的主要操作仍然是单线程处理的。
那 Redis6.0 之前为什么不使用多线程? 我觉得主要原因有 3 点:
- 单线程编程容易并且更容易维护;
- Redis 的性能瓶颈不在 CPU,主要在内存和网络;
- 多线程就会存在死锁、线程上下文切换等问题,甚至会影响性能。
相关阅读:为什么 Redis 选择单线程模型?。
Redis6.0 之后为何引入了多线程?
Redis6.0 引入多线程主要是为了提高网络 IO 读写性能,因为这个算是 Redis 中的一个性能瓶颈(Redis 的瓶颈主要受限于内存和网络)。
虽然,Redis6.0 引入了多线程,但是 Redis 的多线程只是在网络数据的读写这类耗时操作上使用了,执行命令仍然是单线程顺序执行。因此,你也不需要担心线程安全问题。
Redis6.0 的多线程默认是禁用的,只使用主线程。如需开启需要设置 IO 线程数 > 1,需要修改 redis 配置文件 redis.conf:
bash
io-threads 4 #设置1的话只会开启主线程,官网建议4核的机器建议设置为2或3个线程,8核的建议设置为6个线程另外:
- io-threads 的个数一旦设置,不能通过 config 动态设置。
- 当设置 ssl 后,io-threads 将不工作。
开启多线程后,默认只会使用多线程进行 IO 写入 writes,即发送数据给客户端,如果需要开启多线程 IO 读取 reads,同样需要修改 redis 配置文件 redis.conf:
bash
io-threads-do-reads yes但是官网描述开启多线程读并不能有太大提升,因此一般情况下并不建议开启。
相关阅读:
Redis 后台线程了解吗?
我们虽然经常说 Redis 是单线程模型(主要逻辑是单线程完成的),但实际还有一些后台线程用于执行一些比较耗时的操作:
- 通过
bio_close_file后台线程来释放 AOF / RDB 等过程中产生的临时文件资源。 - 通过
bio_aof_fsync后台线程调用fsync函数将系统内核缓冲区还未同步到到磁盘的数据强制刷到磁盘(AOF 文件)。 - 通过
bio_lazy_free后台线程释放大对象(已删除)占用的内存空间.
在bio.h 文件中有定义(Redis 6.0 版本,源码地址:https://github.com/redis/redis/blob/6.0/src/bio.h):
java
#ifndef __BIO_H
#define __BIO_H

/* Exported API */
void bioInit(void);
void bioCreateBackgroundJob(int type, void *arg1, void *arg2, void *arg3);
unsigned long long bioPendingJobsOfType(int type);
unsigned long long bioWaitStepOfType(int type);
time_t bioOlderJobOfType(int type);
void bioKillThreads(void);

/* Background job opcodes */
#define BIO_CLOSE_FILE    0 /* Deferred close(2) syscall. */
#define BIO_AOF_FSYNC     1 /* Deferred AOF fsync. */
#define BIO_LAZY_FREE     2 /* Deferred objects freeing. */
#define BIO_NUM_OPS       3

#endif关于 Redis 后台线程的详细介绍可以查看 Redis 6.0 后台线程有哪些? 这篇就文章。
⭐️Redis 内存管理
Redis 给缓存数据设置过期时间有什么用?
一般情况下,我们设置保存的缓存数据的时候都会设置一个过期时间。为什么呢?
内存是有限且珍贵的,如果不对缓存数据设置过期时间,那内存占用就会一直增长,最终可能会导致 OOM 问题。通过设置合理的过期时间,Redis 会自动删除暂时不需要的数据,为新的缓存数据腾出空间。
Redis 自带了给缓存数据设置过期时间的功能,比如:
bash
127.0.0.1:6379> expire key 60 # 数据在 60s 后过期
(integer) 1
127.0.0.1:6379> setex key 60 value # 数据在 60s 后过期 (setex:[set] + [ex]pire)
OK
127.0.0.1:6379> ttl key # 查看数据还有多久过期
(integer) 56注意 ⚠️:Redis 中除了字符串类型有自己独有设置过期时间的命令 setex 外,其他方法都需要依靠 expire 命令来设置过期时间 。另外,persist 命令可以移除一个键的过期时间。
过期时间除了有助于缓解内存的消耗,还有什么其他用么?
很多时候,我们的业务场景就是需要某个数据只在某一时间段内存在,比如我们的短信验证码可能只在 1 分钟内有效,用户登录的 Token 可能只在 1 天内有效。
如果使用传统的数据库来处理的话,一般都是自己判断过期,这样更麻烦并且性能要差很多。
Redis 是如何判断数据是否过期的呢?
Redis 通过一个叫做过期字典(可以看作是 hash 表)来保存数据过期的时间。过期字典的键指向 Redis 数据库中的某个 key(键),过期字典的值是一个 long long 类型的整数,这个整数保存了 key 所指向的数据库键的过期时间(毫秒精度的 UNIX 时间戳)。
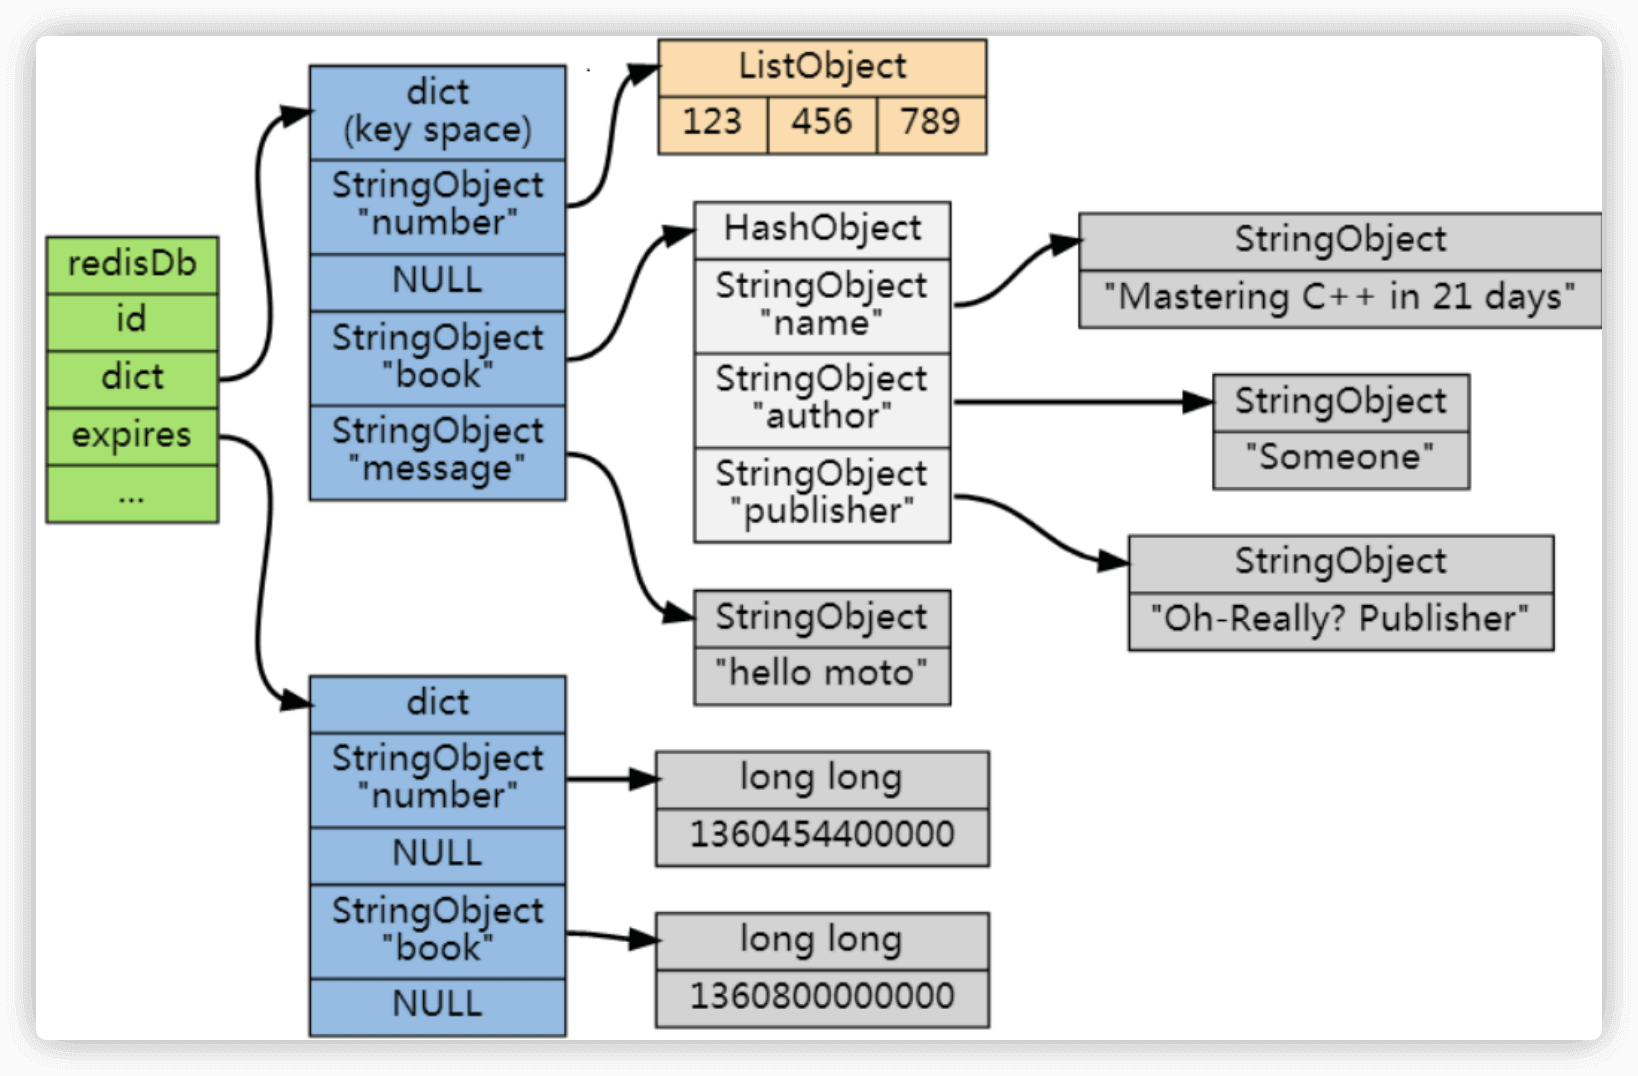
过期字典是存储在 redisDb 这个结构里的:
c
typedef struct redisDb {
    ...

    dict *dict;     //数据库键空间,保存着数据库中所有键值对
    dict *expires   // 过期字典,保存着键的过期时间
    ...
} redisDb;在查询一个 key 的时候,Redis 首先检查该 key 是否存在于过期字典中(时间复杂度为 O(1)),如果不在就直接返回,在的话需要判断一下这个 key 是否过期,过期直接删除 key 然后返回 null。
Redis 过期 key 删除策略了解么?
如果假设你设置了一批 key 只能存活 1 分钟,那么 1 分钟后,Redis 是怎么对这批 key 进行删除的呢?
常用的过期数据的删除策略就下面这几种:
- 惰性删除:只会在取出/查询 key 的时候才对数据进行过期检查。这种方式对 CPU 最友好,但是可能会造成太多过期 key 没有被删除。
- 定期删除:周期性地随机从设置了过期时间的 key 中抽查一批,然后逐个检查这些 key 是否过期,过期就删除 key。相比于惰性删除,定期删除对内存更友好,对 CPU 不太友好。
- 延迟队列:把设置过期时间的 key 放到一个延迟队列里,到期之后就删除 key。这种方式可以保证每个过期 key 都能被删除,但维护延迟队列太麻烦,队列本身也要占用资源。
- 定时删除:每个设置了过期时间的 key 都会在设置的时间到达时立即被删除。这种方法可以确保内存中不会有过期的键,但是它对 CPU 的压力最大,因为它需要为每个键都设置一个定时器。
Redis 采用的是那种删除策略呢?
Redis 采用的是 定期删除+惰性/懒汉式删除 结合的策略,这也是大部分缓存框架的选择。定期删除对内存更加友好,惰性删除对 CPU 更加友好。两者各有千秋,结合起来使用既能兼顾 CPU 友好,又能兼顾内存友好。
下面是我们详细介绍一下 Redis 中的定期删除具体是如何做的。
Redis 的定期删除过程是随机的(周期性地随机从设置了过期时间的 key 中抽查一批),所以并不保证所有过期键都会被立即删除。这也就解释了为什么有的 key 过期了,并没有被删除。并且,Redis 底层会通过限制删除操作执行的时长和频率来减少删除操作对 CPU 时间的影响。
另外,定期删除还会受到执行时间和过期 key 的比例的影响:
- 执行时间已经超过了阈值,那么就中断这一次定期删除循环,以避免使用过多的 CPU 时间。
- 如果这一批过期的 key 比例超过一个比例,就会重复执行此删除流程,以更积极地清理过期 key。相应地,如果过期的 key 比例低于这个比例,就会中断这一次定期删除循环,避免做过多的工作而获得很少的内存回收。
Redis 7.2 版本的执行时间阈值是 25ms,过期 key 比例设定值是 **10%**。
c
#define ACTIVE_EXPIRE_CYCLE_FAST_DURATION 1000 /* Microseconds. */
#define ACTIVE_EXPIRE_CYCLE_SLOW_TIME_PERC 25 /* Max % of CPU to use. */
#define ACTIVE_EXPIRE_CYCLE_ACCEPTABLE_STALE 10 /* % of stale keys after which
we do extra efforts. */每次随机抽查数量是多少?
expire.c 中定义了每次随机抽查的数量,Redis 7.2 版本为 20,也就是说每次会随机选择 20 个设置了过期时间的 key 判断是否过期。
c
#define ACTIVE_EXPIRE_CYCLE_KEYS_PER_LOOP 20 /* Keys for each DB loop. */如何控制定期删除的执行频率?
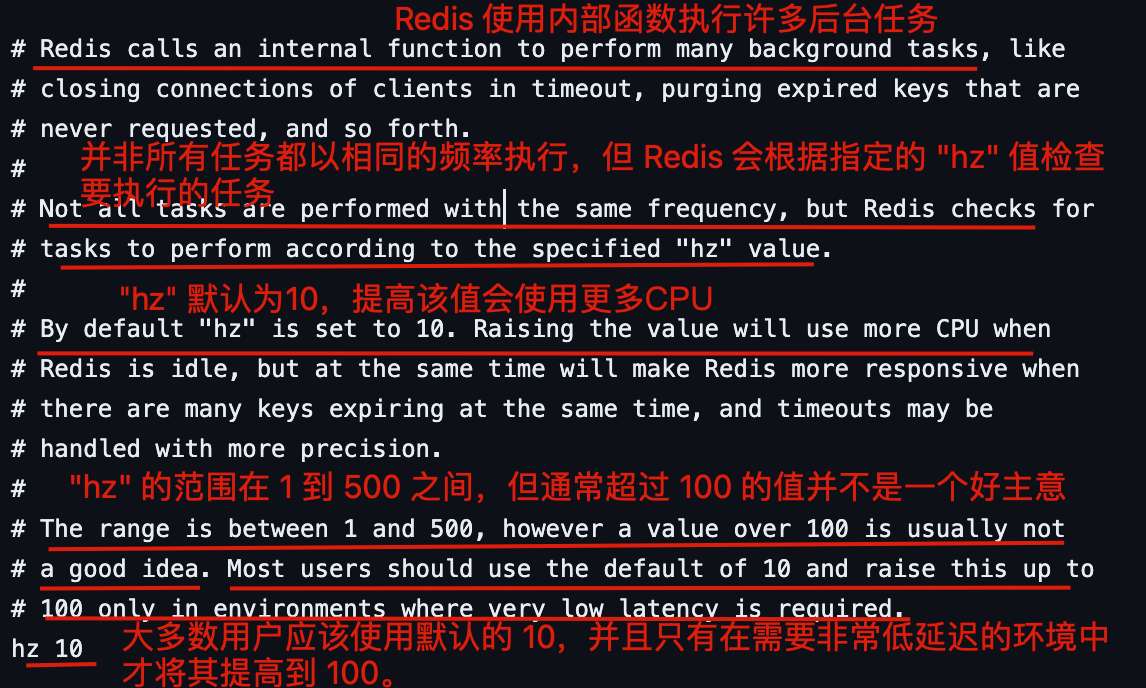
在 Redis 中,定期删除的频率是由 hz 参数控制的。hz 默认为 10,代表每秒执行 10 次,也就是每秒钟进行 10 次尝试来查找并删除过期的 key。
hz 的取值范围为 1~500。增大 hz 参数的值会提升定期删除的频率。如果你想要更频繁地执行定期删除任务,可以适当增加 hz 的值,但这会增加 CPU 的使用率。根据 Redis 官方建议,hz 的值不建议超过 100,对于大部分用户使用默认的 10 就足够了。
下面是 hz 参数的官方注释,我翻译了其中的重要信息(Redis 7.2 版本)。
类似的参数还有一个 dynamic-hz,这个参数开启之后 Redis 就会在 hz 的基础上动态计算一个值。Redis 提供并默认启用了使用自适应 hz 值的能力,
这两个参数都在 Redis 配置文件 redis.conf 中:
properties
# 默认为 10
hz 10
# 默认开启
dynamic-hz yes多提一嘴,除了定期删除过期 key 这个定期任务之外,还有一些其他定期任务例如关闭超时的客户端连接、更新统计信息,这些定期任务的执行频率也是通过 hz 参数决定。
为什么定期删除不是把所有过期 key 都删除呢?
这样会对性能造成太大的影响。如果我们 key 数量非常庞大的话,挨个遍历检查是非常耗时的,会严重影响性能。Redis 设计这种策略的目的是为了平衡内存和性能。
为什么 key 过期之后不立马把它删掉呢?这样不是会浪费很多内存空间吗?
因为不太好办到,或者说这种删除方式的成本太高了。假如我们使用延迟队列作为删除策略,这样存在下面这些问题:
- 队列本身的开销可能很大:key 多的情况下,一个延迟队列可能无法容纳。
- 维护延迟队列太麻烦:修改 key 的过期时间就需要调整其在延迟队列中的位置,并且还需要引入并发控制。
大量 key 集中过期怎么办?
当 Redis 中存在大量 key 在同一时间点集中过期时,可能会导致以下问题:
- 请求延迟增加:Redis 在处理过期 key 时需要消耗 CPU 资源,如果过期 key 数量庞大,会导致 Redis 实例的 CPU 占用率升高,进而影响其他请求的处理速度,造成延迟增加。
- 内存占用过高:过期的 key 虽然已经失效,但在 Redis 真正删除它们之前,仍然会占用内存空间。如果过期 key 没有及时清理,可能会导致内存占用过高,甚至引发内存溢出。
为了避免这些问题,可以采取以下方案:
- 尽量避免 key 集中过期:在设置键的过期时间时尽量随机一点。
- 开启 lazy free 机制:修改
redis.conf配置文件,将lazyfree-lazy-expire参数设置为yes,即可开启 lazy free 机制。开启 lazy free 机制后,Redis 会在后台异步删除过期的 key,不会阻塞主线程的运行,从而降低对 Redis 性能的影响。
Redis 内存淘汰策略了解么?
相关问题:MySQL 里有 2000w 数据,Redis 中只存 20w 的数据,如何保证 Redis 中的数据都是热点数据?
Redis 的内存淘汰策略只有在运行内存达到了配置的最大内存阈值时才会触发,这个阈值是通过 redis.conf 的 maxmemory 参数来定义的。64 位操作系统下,maxmemory 默认为 0,表示不限制内存大小。32 位操作系统下,默认的最大内存值是 3GB。
你可以使用命令 config get maxmemory 来查看 maxmemory 的值。
bash
> config get maxmemory
maxmemory
0Redis 提供了 6 种内存淘汰策略:
- volatile-lru(least recently used):从已设置过期时间的数据集(
server.db[i].expires)中挑选最近最少使用的数据淘汰。 - volatile-ttl:从已设置过期时间的数据集(
server.db[i].expires)中挑选将要过期的数据淘汰。 - volatile-random:从已设置过期时间的数据集(
server.db[i].expires)中任意选择数据淘汰。 - allkeys-lru(least recently used):从数据集(
server.db[i].dict)中移除最近最少使用的数据淘汰。 - allkeys-random:从数据集(
server.db[i].dict)中任意选择数据淘汰。 - no-eviction(默认内存淘汰策略):禁止驱逐数据,当内存不足以容纳新写入数据时,新写入操作会报错。
4.0 版本后增加以下两种:
- volatile-lfu(least frequently used):从已设置过期时间的数据集(
server.db[i].expires)中挑选最不经常使用的数据淘汰。 - allkeys-lfu(least frequently used):从数据集(
server.db[i].dict)中移除最不经常使用的数据淘汰。
allkeys-xxx 表示从所有的键值中淘汰数据,而 volatile-xxx 表示从设置了过期时间的键值中淘汰数据。
config.c 中定义了内存淘汰策略的枚举数组:
c
configEnum maxmemory_policy_enum[] = {
    {"volatile-lru", MAXMEMORY_VOLATILE_LRU},
    {"volatile-lfu", MAXMEMORY_VOLATILE_LFU},
    {"volatile-random",MAXMEMORY_VOLATILE_RANDOM},
    {"volatile-ttl",MAXMEMORY_VOLATILE_TTL},
    {"allkeys-lru",MAXMEMORY_ALLKEYS_LRU},
    {"allkeys-lfu",MAXMEMORY_ALLKEYS_LFU},
    {"allkeys-random",MAXMEMORY_ALLKEYS_RANDOM},
    {"noeviction",MAXMEMORY_NO_EVICTION},
    {NULL, 0}
};你可以使用 config get maxmemory-policy 命令来查看当前 Redis 的内存淘汰策略。
bash
> config get maxmemory-policy
maxmemory-policy
noeviction可以通过 config set maxmemory-policy 内存淘汰策略 命令修改内存淘汰策略,立即生效,但这种方式重启 Redis 之后就失效了。修改 redis.conf 中的 maxmemory-policy 参数不会因为重启而失效,不过,需要重启之后修改才能生效。
properties
maxmemory-policy noeviction关于淘汰策略的详细说明可以参考 Redis 官方文档:https://redis.io/docs/reference/eviction/。
参考
- 《Redis 开发与运维》
- 《Redis 设计与实现》
- 《Redis 核心原理与实战》
- Redis 命令手册:https://www.redis.com.cn/commands.html
- RedisSearch 终极使用指南,你值得拥有!:https://mp.weixin.qq.com/s/FA4XVAXJksTOHUXMsayy2g
- WHY Redis choose single thread (vs multi threads): https://medium.com/@jychen7/sharing-redis-single-thread-vs-multi-threads-5870bd44d153