主题
整理自沉默王二(二哥)javabetter.cn《AI Agent 面试 296 题合集》:原文。全文搬运仅供个人学习,请勿外传。
2025 年开始,大厂面试出现了一个明显的转向。传统的八股文比重在降,取而代之的是 Agent 相关的问题。字节、阿里、腾讯、蚂蚁、快手、小红书,几乎每一家都在问「你做过 Agent 项目吗」「RAG 检索怎么做的」「MCP 协议了解吗」。不光是面试,整个行业的技术栈也在往 Agent 方向迁移。Claude Code、Codex 这些产品已经不是概念验证了,它们在真实的生产环境里跑着,每天帮我们写代码、改 bug、做 Code Review。
甚至今年下半年涌现了一大批桌面Agent,包括WorkBuddy、豆包工作、千问办公等的。
模型也在不断升级,DeepSeek V4、Kimi K3、GLM-5.3、Fable 5、GPT-6 Astra 等等。
这意味着两件事。
第一,Agent 不再是「了解即可」的加分项,而是后端和 AI 方向求职的必答题。你不需要成为 Agent 框架的贡献者,但你得说清楚 ReAct 怎么控制迭代、上下文窗口爆了怎么压缩、RAG 的混合检索怎么设计、Prompt Caching 的命中条件是什么。这些问题,已经是面试中的常客了。
第二,理解 Agent 的工作原理也会直接提升你使用 AI 工具的效率。知道 Context Engineering 的人,写 Prompt 的质量和不知道的人完全是两个水平。
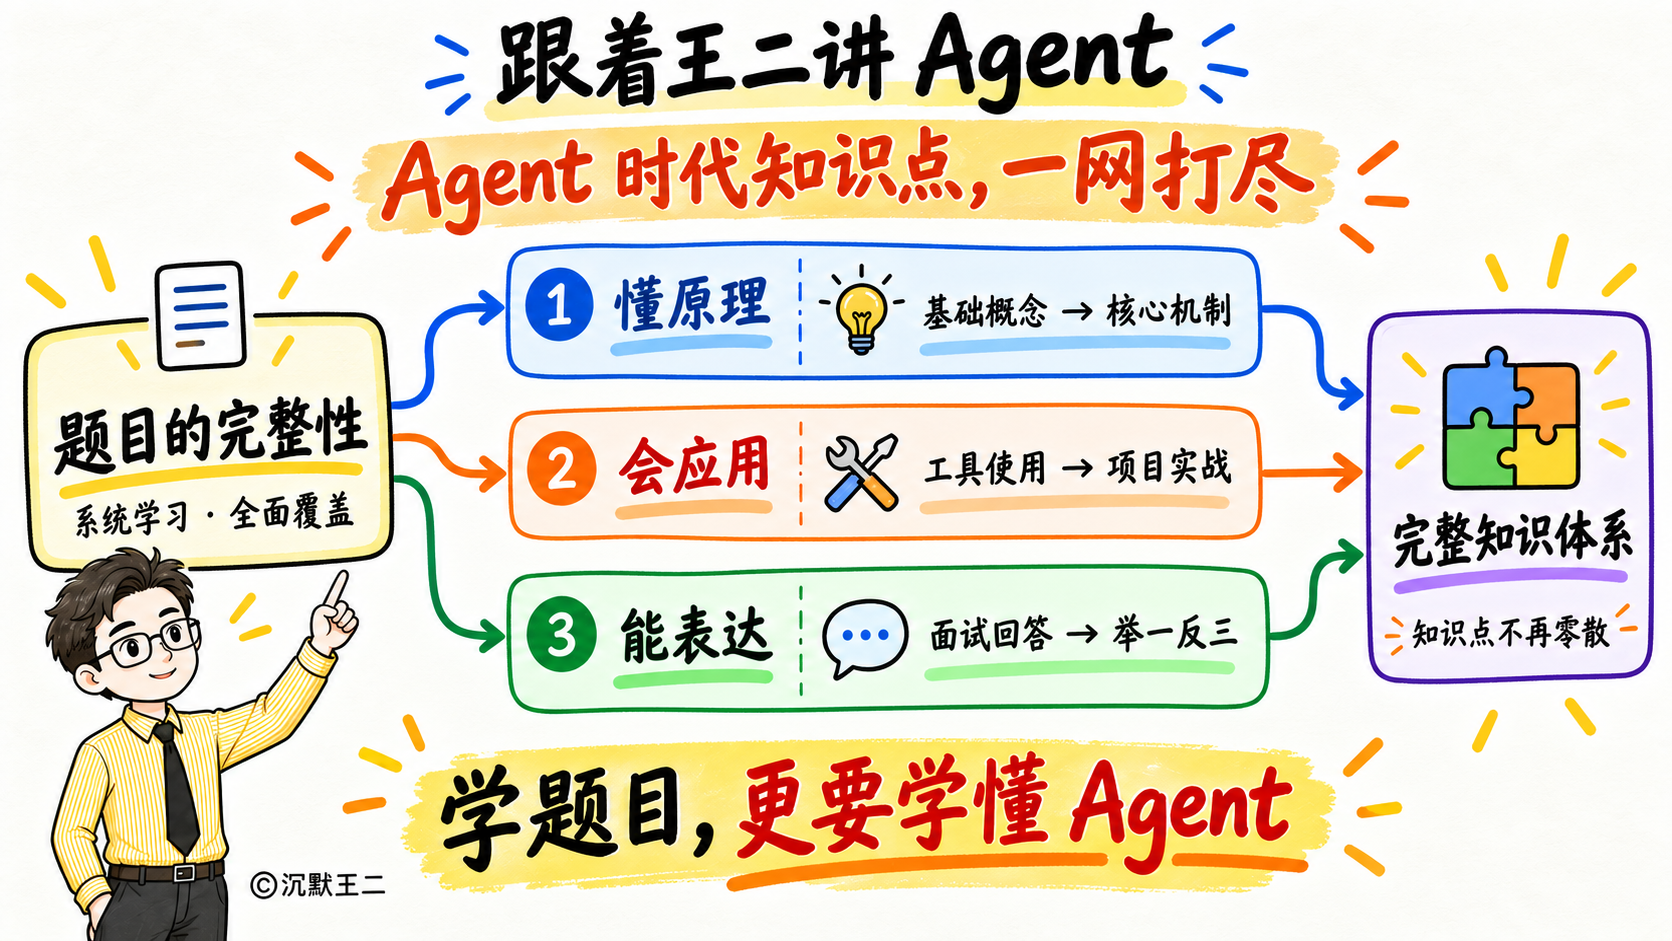
这套题库一共 296 道(还会持续追加),覆盖 Agent 基础、上下文与记忆、Harness、RAG、LLM、Claude Code、Codex、DeepSeek、Prompt、MCP、LangChain、Spring AI 和模型微调。题目来源是牛客、星球、各大厂真实面经,按出现频次和难度权重筛选,随着视频更新持续补充。
每道题都不是孤立的概念解释,而是串联到三个实战项目来回答。
- PaiAgent/PaiFlow,LangGraph4j + Spring AI 的工作流编排平台
- PaiCLI,对标 Claude Code 的 终端 Agent
- 派聪明,基于 ES 混合搜索的 RAG 知识库
每一道题的回答都有项目代码可以兜底。
题目难度分三级:🟢 基础、🟡 进阶、🔴 深入。已完成图文解析和视频讲解的题目会标注链接,方便按图索骥。
分类与排序说明:前 7 个分类与网站侧边栏保持一致,后 4 个分类为 README 独有专项,中间的「热点解读」是模型发布和行业事件的拆解;每类优先展示已有视频和完整答案的题目,疑似重复题放在分类末尾,确认前暂不删除。
你也可以加我的微信【备注AI】,小助理会拉你进AI交流群的。
01、Agent 基础(26 题)
聚焦 Agent 的定义、工作方式、规划、反思、多 Agent 协作,以及常见 Agent 产品和框架。
1. 什么是 Agent?和直接调大模型 API 有什么本质区别?
大模型只会“接收输入→生成输出”,Agent 在此基础上加了感知环境、自主决策、调用工具、迭代反馈的能力。一个是被动的问答机器,一个是能自己动手干活的智能体。
完整答案:查看图文解析
B站视频:观看本集视频
🟢 基础 | → PaiCLI | 字节、腾讯、阿里
2. Agent 和 ChatBot 最大的区别是什么?
可以按一次任务闭环来回答:先理解用户目标并做规划(Planning),再维护上下文和长期记忆(Memory),按需选择外部工具(Tool Use),执行行动并根据观察结果继续迭代(Action/Observation)。
落到 PaiCLI,就是 Plan-and-Execute 负责任务拆解,Memory 管理上下文和长期信息,MCP 接入外部工具,ReAct 循环把工具结果反馈回来继续决策。
完整答案:查看图文解析
B站视频:观看本集视频
🟢 基础 | → PaiCLI | 字节、阿里云
3. Workflow 和 Agent 有什么区别?
Agent 是能自主决策调用 Tools 的智能体,Workflow 是多个 Agent 或步骤按预设流程编排。PaiAgent 就是 Workflow 层面的产品,PaiCLI 是 Agent 层面的产品,它们都调用各种 Tools。
完整答案:查看图文解析
B站视频:观看本集视频
🟢 基础 | → PaiCLI(Agent)
4. 说说 Agent 是如何工作的?
Agent 接收目标后,会组装上下文、调用模型决策、执行工具、写回观察结果,并判断继续执行还是结束。
完整答案:查看图文解析
B站视频:观看本集视频
🟡 进阶 | → PaiCLI | 字节、淘天、阿里云
5. 一个 Agent 有哪些核心组件?
生产级 Agent 通常由模型、工具、记忆、规划与 Harness 五部分组成。模型负责理解与决策,工具负责执行,记忆保存任务状态和长期信息,规划决定行动顺序,Harness 负责权限、循环、上下文和错误恢复。
完整答案:查看图文解析
B站视频:观看本集视频
🟢 基础 | → PaiCLI | 字节、阿里
6. Agent 怎么知道该调用哪个工具?
NEW 新增题目
工具选择主要由 LLM 根据工具名称、描述和参数 Schema 完成,Agent 运行时负责注册、执行、校验与结果回传。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1m9j16DEmv/)
7. 到底什么是 ReAct?和 CoT 有什么区别?
面试出现频率最高的一道,没有之一。能说清 Thought→Action→Observation 的循环机制是及格线,能讲清自己项目里怎么控制最大迭代次数、怎么处理工具返回异常才是加分项。
完整答案:查看图文解析
B站视频:观看本集视频
🟡 进阶 | → PaiCLI | 淘天、腾讯、字节、百度
8. ReAct 会死循环吗?
完整答案:查看图文解析
B站视频:观看本集视频
9. 什么是 Plan-and-Execute?
ReAct 和 Plan-and-Execute 是两种任务推进范式:ReAct 走 Thought→Action→Observation 循环,适合信息不确定、需要边查边判断的任务;Plan-and-Execute 先做全局规划,再逐步执行和必要时重规划,适合目标明确、步骤较多的复杂任务。
完整答案:查看图文解析
B站视频:观看本集视频
🟡 进阶 | → PaiCLI | 淘天、腾讯
10. Multi-Agent 协作是怎么实现的?
多 Agent 协作需要明确角色、任务分发、上下文隔离、结果聚合和冲突处理,而不只是同时启动多个模型会话。
完整答案:查看图文解析
B站视频:观看本集视频
🟡 进阶 | → PaiCLI | 字节、阿里云、蚂蚁、小红书
11. Agent 的 Planning 模块有哪些实现方式?
常见方式包括根据工具结果逐步决策(如 ReAct)、先规划后执行(Plan-and-Execute),以及根据执行反馈调整剩余任务(Plan-Execute-Replan)。这些方式可以组合;需要程序调度时,还可以把任务表示成带依赖的 DAG。工具界面上的 Plan 模式主要组织规划与审阅,具体操作的权限限制要看独立的沙箱和审批实现。
完整答案:[查看图文解析
🟡 进阶 | → PaiCLI | 字节、阿里、腾讯
12. Agent 的反思机制是什么?为什么需要反思?
反思就是让 Agent 评估自己的输出质量,发现错误就自我修正。没有反思的 Agent 犯了错只会一条路走到黑。
🟡 进阶 | → PaiCLI
13. 为什么你选择手搓 Agent 而不用框架?
框架(LangChain、LlamaIndex)封装太重。
🟡 进阶 | → PaiCLI
14. Agent 怎么做经验积累和自我学习?
Skill
🔴 深入 | → PaiCLI
15. 多 Agent 协作时意见冲突怎么统一?
常见方案有投票机制(少数服从多数)、裁判 Agent(专门做最终决策)、层级委派(上级 Agent 拍板)。
🔴 深入 | → PaiCLI | 字节、阿里
16. 什么是 Manus?说说你对它的了解
🟢 简单 | AI / 大模型 / Manus | → PaiAgent / PaiCLI
17. Computer Use 是什么?说说它的原理
🟡 中等 | AI / 大模型 | → PaiAgent / PaiCLI
18. Copilot 模式和 Agent 模式的区别是什么?
🟡 中等 | AI / 大模型 | → PaiAgent / PaiCLI
19. LLM Agent 在多模态任务中如何执行推理?
🔴 困难 | 大模型 / AI / Agent | → PaiAgent / PaiCLI
20. 市面上有哪些主流的 LLM Agent 框架?各自的特点是什么?
🟢 简单 | 大模型 / AI / Agent | → PaiAgent / PaiCLI
21. AutoGPT 如何实现自主决策?
🔴 困难 | 大模型 / AI / Agent / AutoGPT | → PaiCLI / PaiAgent Agent 范式对比
22. 什么是 Google ADK?
🟢 简单 | AI / 大模型 | → PaiAgent / PaiCLI
23. 什么是 OpenManus?它的实现原理是什么?
🔴 困难 | 后端 | → PaiAgent / PaiCLI
24. 最近 OpenClaw 这么火,你知道它的原理吗?
🟢 简单 | AI / OpenClaw / 大模型应用开发 / Agent 开发 / AI 应用开发 | → PaiAgent / PaiCLI
25. OpenClaw 是什么?它要解决什么问题?它的核心能力有哪些?
🟢 简单 | AI / OpenClaw / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
26. Agent 死循环问题有遇到过吗?如何解决?
REVIEW 疑似重复 · 待确认:与「ReAct 会死循环吗?」内容重合
🟡 中等 | `后端 / AI / 大模型 / 场景题` | → PaiAgent / PaiCLI02、上下文与记忆(15 题)
聚焦上下文窗口、Context Engineering、短期记忆、长期记忆、压缩、检索与会话隔离。
27. 什么是上下文工程(Context Engineering)?
NEW 新增题目
上下文工程关注在正确时机把正确的信息放进有限窗口,包括系统指令、记忆、工具定义、检索结果和历史压缩。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1RHM768EjW/)
28. Agent 的上下文窗口是什么?
NEW 新增题目
上下文窗口是模型单次推理可读取的 Token 总预算,系统提示、工具定义、历史消息和工具结果都会占用它。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1oGKG65E6G/)
29. 为什么 LLM 的上下文窗口不能无限大?
NEW 新增题目
上下文越长,注意力计算、显存占用和推理延迟越高,还会出现中间信息利用率下降,因此窗口不能无限扩展。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1UbMi6BEet/)
30. Agent 怎么避免上下文爆炸?
NEW 新增题目
控制 Agent 上下文需要结合工具输出截断、历史摘要、Sub-agent 隔离和按需加载,而不是简单删除旧消息。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1oqMt6FEEH/)
31. 为什么聊着聊着 Agent 就变笨了?
NEW 新增题目
长对话会引入噪声、指令冲突、注意力稀释和压缩损失,导致 Agent 对关键约束的利用率下降。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1TH3j6pEno/)
32. 为什么说 LLM 本身没有记忆?
NEW 新增题目
LLM 每次请求只根据当前输入计算输出,不会自动保存上轮状态。对话记忆来自应用层重新注入历史消息或读取外部存储。
完整答案:查看图文解析
33. 怎么让 Agent 拥有记忆?
NEW 新增题目
Agent 记忆需要区分当前任务状态与跨会话知识,通过筛选、存储、检索、注入和遗忘机制共同实现。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1bWKH6ZE9J/)
34. Agent 的短期记忆怎么实现?
NEW 新增题目
Agent 的短期记忆通常保存当前会话消息、任务状态和工具结果,并通过窗口裁剪与摘要压缩控制 Token 使用。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1fGKA6pEcv/)
35. Agent 的长期记忆怎么实现?
NEW 新增题目
Agent 的长期记忆把跨会话有效信息持久化,并在新任务中按相关性与权限检索,再以受控方式注入上下文。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1yR3k6REFM/)
36. Agent 记忆压缩通常有哪些方法?
主流三种:摘要压缩(把 10 轮对话压成一段摘要)、实体提取(只保留关键实体和关系)、向量化存储(记忆转向量,按相似度召回)。
🟡 进阶 | → PaiCLI | 腾讯
37. 长期记忆的 FIFO 淘汰有什么问题?怎么优化?
FIFO 最大的坑是把重要但不常用的记忆淘汰掉了。
🔴 深入 | → PaiCLI | 腾讯
38. 长上下文压缩有哪些方案?
主流方案有三种:对话摘要(把历史对话压缩成一段摘要)、关键信息提取(只保留重要的事实和决策)、滑动窗口(只保留最近 N 轮)。PaiCLI 支持 1M token 窗口的模型,同时配合动态压缩策略,在窗口快满时自动触发压缩。
🟡 进阶 | → PaiCLI 动态压缩 + 1M token 窗口 | 快手、淘天、拼多多、腾讯
39. 同一个用户在私聊和群组里和 Agent 对话,应该共享会话还是隔离?OpenClaw 是怎么设计会话隔离粒度的?
🟡 中等 | AI / OpenClaw / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
40. Agent 的短期记忆和长期记忆分别怎么实现?
REVIEW 疑似重复 · 待确认:与「怎么让 Agent 拥有记忆?」等 3 道已更新记忆题内容重合
短期记忆就是当前对话上下文,长期记忆需要持久化存储跨会话的事实。🟡 进阶 | → PaiCLI | 淘天、快手
41. LLaMA 模型中,输入句子的长度理论上是否可以无限长?
REVIEW 疑似重复 · 待确认:与「为什么 LLM 的上下文窗口不能无限大?」内容重合
🔴 困难 | `自然语言处理(NLP) / 大语言模型` | → PaiCLI / PaiAgent 大模型应用基础03、Harness 与 Skills(34 题)
聚焦模型之外保障 Agent 稳定运行的工程系统,包括循环、Skills、评测、安全、权限、可观测性、成本、容错和发布。
42. 什么是 Harness Engineering?
NEW 新增题目
Harness Engineering 关注模型之外的循环控制、工具执行、权限、上下文、错误恢复和可观测性,是生产级 Agent 的运行基础。
完整答案:查看图文解析](https://www.bilibili.com/video/BV185NC6nEho/)
43. 什么是 Loop Engineering?
NEW 新增题目
Loop Engineering 通过明确目标、反馈、校验、预算与退出条件,让 Agent 可以持续迭代又不会无边界运行。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1q5NQ6pEPg/)
44. Agent 挂了几十个 Skill,怎么保证命中率?
NEW 新增题目
提高 Skill 命中率依赖清晰描述、分层发现、按需加载、候选召回与冲突消解,不能只靠硬编码路由。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1Lfjy6bEKY/)
45. 多轮工具调用,怎么判断该继续调用还是该停?
两种策略:一是模型自己判断(返回的 finish_reason 不含 tool_calls 时停止),二是工程侧兜底(设最大迭代次数)。
🟡 进阶 | → PaiCLI | 淘天
46. Token 预算管理怎么做?
在模型调用前估算本次请求的 token 用量,如果超预算就先压缩上下文。PaiCLI 支持 Prompt Cache 可视化,让用户能看到每次请求的 token 消耗分布(系统提示词占了多少、历史对话占了多少、工具描述占了多少),方便针对性优化。
🟡 进阶 | → PaiCLI 动态预算 + Prompt Cache 可视化
47. 大模型部署有哪些主流方案?vLLM、TGI、llama.cpp 怎么选?
vLLM(PagedAttention,显存利用率高,适合高并发在线服务)、TGI(HuggingFace 出品,和 HF 生态集成好)、llama.cpp(C++ 实现,CPU/低端 GPU 也能跑)、SGLang(RadixAttention,适合复杂 Prompt 复用场景)。生产环境高并发首选 vLLM。
🟡 进阶
48. 有没有用过大模型网关框架?网关层解决了什么问题?
大模型网关(如 LiteLLM、OneAPI)统一管理多个模型提供商的 API 密钥、请求路由、限流、重试、负载均衡。PaiAgent 的 ChatClientFactory 其实就承担了部分网关职责,根据节点配置动态路由到不同的模型服务。生产环境建议上专门的网关。
🟡 进阶 | → PaiAgent ChatClientFactory 路由功能
49. Agent 系统从 demo 到生产级落地要走哪些流程?
需求定义 → 技术选型 → 原型验证 → 工具集成 → 评测体系搭建 → 安全审计 → 灰度发布 → 监控告警。PaiAgent 的完整落地历程就经历了这些阶段,从单节点 DAG 到 LangGraph4j 双引擎的演进过程本身就是很好的面试素材。
🟡 进阶 | → PaiAgent 从 DAG 到 LangGraph4j 的演进 | 万类智生、蚂蚁、字节、腾讯
50. Agent 的执行效果怎么评估?
三个维度:任务完成率(Agent 能不能把事干完)、回答质量(输出是否准确有用)、用户满意度(人工评分或隐式反馈)。PaiAgent 的执行记录会以成功/失败状态写入数据库,方便后续统计分析。量化指标能拿出来说的候选人凤毛麟角。
🔴 深入 | → PaiAgent 执行记录 + 状态追踪 | 数坤科技、字节
51. 大模型能力评测指标有哪些?
通用能力看 MMLU(多学科知识)、HumanEval(代码生成)、GSM8K(数学推理)。中文场景看 C-Eval、CMMLU。对话能力看 MT-Bench、Chatbot Arena ELO 排名。RAG 场景看 RAGAS。选型时不能只看一个榜,要结合自己场景做私有评测。
🟡 进阶
52. Agent 响应太慢怎么优化?
工程侧:工具调用并行化、缓存高频查询结果、流式输出减少用户等待感。基座侧:用更快的模型做初筛(比如 Haiku),复杂任务再调大模型。PaiAgent 的 TTS 模块就用了 CompletableFuture 做并行处理,多个音频片段同时生成。
🟡 进阶 | → PaiAgent CompletableFuture 并行 / PaiCLI 多模型切换
53. Agent 系统有哪些安全风险?怎么防范?
三大风险:Prompt Injection(恶意指令注入)、沙箱逃逸(Agent 执行了不该执行的系统命令)、越权操作(Agent 访问了不该访问的数据)。PaiCLI 的防范体系包括 HITL 人工审批、路径围栏、命令黑名单、结构化审计日志四道防线。
🔴 深入 | → PaiCLI 四道安全防线
54. Skill 预置知识包机制是什么?怎么设计的?
Skill 是把某个专业领域的最佳实践封装成结构化知识包,Agent 执行任务时自动加载对应 Skill 的指南和参考文档。PaiAgent 的 SkillRegistry 在应用启动时一次性加载所有 Skill 到 ConcurrentHashMap,支持全量注入和渐进式加载两种模式。PaiCLI 也有独立的 Skill 系统,还多了站点经验库的积累能力。
🟡 进阶 | → PaiAgent SkillRegistry / PaiCLI Skill + 站点经验
55. 多工具调度引擎怎么设计?工具之间有依赖怎么处理?
核心是拓扑排序。先分析工具之间的输入输出依赖关系,构建 DAG,然后按拓扑序执行。PaiAgent 的 GraphBuilder 就是干这事的,通过边的 source/target 关系构建执行图,没有入边的节点先执行。
🔴 深入 | → PaiAgent GraphBuilder 拓扑构建 | 字节、阿里云
56. Agent 流式输出怎么设计?怎么提升用户体验?
模型还在“想”的时候就开始给用户展示中间结果。PaiCLI 在 ReAct 循环中实时展示 Thought(“我在想...”)、Action(“正在调用 xxx 工具”)、Observation(“工具返回了...”),让用户看到 Agent 的思考过程而不是干等一个最终结果。
🟡 进阶 | → PaiCLI ReAct 过程可视化
57. Agent 系统的可观测性怎么做?需要监控哪些指标?
核心指标:请求成功率、平均响应时间、token 消耗量、工具调用成功率、模型 API 错误率。PaiAgent 的每次工作流执行都记录完整的执行日志(每个节点的输入输出、耗时、状态),出了问题能快速定位是哪个节点挂了。
🟡 进阶 | → PaiAgent 执行日志 + 节点级追踪
58. Agent 灰度发布怎么做?
不能一次性把新版 Agent 推给所有用户。常见做法是按用户 ID 或流量比例分桶,先让 5% 的用户用新版,观察一段时间(错误率、满意度)没问题再逐步扩大。PaiAgent 可以通过工作流配置实现 A/B 测试,同一个任务走两套不同的节点编排。
🟡 进阶 | → PaiAgent 工作流 A/B 配置
59. Agent 系统的成本怎么控制?
大模型 API 按 token 计费,成本失控是真实风险。控制手段:设用户级别的 token 配额、用小模型做初筛(PaiCLI 支持多模型切换)、Prompt Cache 减少重复计算、批量请求合并。派聪明就设了聊天消息每分钟 30 次的速率限制。
🟡 进阶 | → PaiCLI 多模型切换 / 派聪明速率限制
60. Agent 系统怎么做容错?单点故障怎么处理?
工具调用失败要有重试和降级策略,模型 API 挂了要能自动切换到备用模型,消息队列保证异步任务不丢。PaiAgent 的节点执行失败会把 status 设为 FAILED 并记录 errorMessage,上层可以根据失败类型决定重试还是跳过。
🟡 进阶 | → PaiAgent FAILED 状态 + 错误记录
61. 数据标注在 Agent 项目中有多重要?怎么做?
评测数据集需要人工标注“标准答案”,Prompt 优化需要标注“好回答 vs 坏回答”,微调需要高质量的指令-回答对。标注质量直接决定了模型效果的上限。可以用 AI 辅助标注(先让模型生成初版,人工校正),效率能提升 3-5 倍。
🟡 进阶
62. Agent 项目如何处理合规与用户隐私?
用户输入可能包含敏感信息(个人信息、商业机密),不能直接存储或发送给第三方模型。处理方式:输入脱敏、审计日志加密、模型 API 选择数据不出境的国内厂商、用户明确授权后才开启数据收集。派聪明的多租户隔离也是合规要求之一。
🟡 进阶 | → 派聪明多租户隔离
63. 你在 Agent 项目中遇到的最大技术挑战是什么?
开放题,但最能看出候选人的真实水平。建议准备 2-3 个真实案例:一个架构层面的(比如 PaiAgent 从 DAG 引擎迁移到 LangGraph4j 双引擎的决策过程),一个工程层面的(比如 PaiCLI 上下文爆炸的优化方案),一个业务层面的(比如派聪明多租户权限隔离的需求变更)。
🔴 深入 | → 三个项目各准备一个案例
64. 什么是护栏技术?
🟢 简单 | AI / 大模型 | → PaiAgent / PaiCLI
65. OpenClaw 的核心组件有哪些?请描述它们之间的关系
🟡 中等 | AI / OpenClaw / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
66. 如果一个 Agent 系统要同时接入 Web、飞书、钉钉等渠道,你会怎么设计渠道抽象层?OpenClaw 的 Channel Plugin 接口是怎么设计的?
🟢 简单 | AI / OpenClaw / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
67. 如何设计和管理 AI Agent 的 Skills 体系?在实际项目中有哪些挑战?
🟡 中等 | AI / 大模型 / Agent / Skills | → PaiAgent / PaiCLI
68. 同一个系统里可能有多个 Agent,不同渠道用户群组的消息需要路由到不同的 Agent。你会怎么设计这个路由?OpenClaw 的路由匹配优先级是怎样的?
🟡 中等 | AI / OpenClaw / 大模型应用开发 / Agent开发 / AI应用开发 | → PaiAgent / PaiCLI
69. 同一个工具(比如「执行命令」)在不同场景下应该有不同的权限。你会怎么设计工具的权限控制?OpenClaw 的工具策略管道是怎么分层的?
🟡 中等 | AI / OpenClaw / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
70. Agent 系统中 Hook 中间件模式有什么用?能举几个典型场景吗?OpenClaw 的 Hook 系统是怎么设计的?
🟡 中等 | AI / OpenClaw / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
71. 父 Agent spawn 子 Agent 时,有哪些边界问题需要考虑?OpenClaw 做了哪些限制和保护?
🟡 中等 | AI / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
72. OpenClaw 采用插件架构,第三方可以注册新渠道、工具、Hook。设计一个插件系统需要考虑哪些关键问题?OpenClaw 的插件 API 长什么样?
🟡 中等 | AI / OpenClaw / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
73. OpenClaw 的 Gateway 对 Agent 请求做了幂等性处理。为什么 Agent 系统特别需要幂等性?工具已经产生副作用时怎么办?
🟡 中等 | AI / OpenClaw / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
74. 如果一个GPU集群的LLM处理能力为1000tokenss,那1000个用户同时并发访问,响应给每个用户的性能只有1 tokens吗?怎么分析性能瓶颈
🟡 中等 | 后端 / 场景题 / 大模型 | → PaiCLI / PaiAgent
75. 什么是 AI 编程中的自动修复循环(Auto-fix Loop)?它的工作流程和退出策略怎么设计?
🟢 简单 | AI Coding / 自动修复循环 / 退出策略 | → PaiCLI / PaiAgent
04、RAG知识库(40 题)
聚焦文档解析、分块、向量检索、混合搜索、Rerank、Agentic RAG、权限隔离与生产优化。
76. Agent 的 RAG 遇到 PDF 怎么办?
NEW 新增题目
PDF RAG 需要同时处理版面、段落、表格、图片和引用位置,常见做法是结构化解析、分块检索与多模态补充。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1FSKZ62ETR/)
77. 为什么需要 RAG?直接把文档塞给大模型不行吗?
上下文窗口有限、塞太多 token 费钱又慢、模型对长文档的“注意力”分配不均匀(中间内容容易被忽略)。RAG 的核心价值是“先检索再生成”,只把最相关的片段喂给模型。
🟢 基础 | → 派聪明整体架构 | 字节、淘天
78. RAG 和微调怎么选?各自适合什么场景?
RAG 适合知识频繁更新、需要溯源的场景(客服、文档问答);微调适合需要改变模型行为风格、固定领域的场景(医疗、法律术语)。可以先微调让模型熟悉领域术语,再用 RAG 补充最新知识。
🟢 基础 | → 派聪明(RAG 路线)
79. 描述一下完整的 RAG 系统工作流程?
文档索引(解析→分块→向量化→入库)→ 查询处理(查询向量化→KNN 召回→关键词匹配与权限过滤→BM25 rescore)→ 生成(拼接检索结果 + 用户问题→LLM 生成→引用标注)。
🟢 基础 | → 派聪明完整实现 | 字节、快手
80. 文档分块策略怎么设计?chunk 大小怎么定?
🟡 进阶 | → 派聪明 ParseService | 快手、字节、Moka、阿里
81. 怎么规避语义被切割掉的问题?
三个手段:重叠切分(相邻 chunk 留重叠区)、按自然语义边界切分(段落、句号、标题)、递归切分(先按大结构切,不够再细分)。
🟡 进阶 | → 派聪明
82. Embedding 模型怎么选型?维度越高越好吗?
不是。维度高意味着存储成本高、检索速度慢。
🟡 进阶 | → 派聪明 Embedding 2048 维 | 快手、阿里
83. Embedding 有哪几种算法?各自的特点是什么?
Word2Vec(静态词向量,不考虑上下文)、BERT 类(双向编码,适合短文本语义匹配)、Sentence Transformers(专门做句子级别嵌入)、BGE/GTE 系列(中文优化,MTEB 榜单前列)。派聪明默认走阿里 text-embedding-v4,维度 2048,也预留了智谱 embedding-3 这类 OpenAI 兼容 Embedding Provider 的切换路径。
🟡 进阶 | → 派聪明选型依据
84. 向量数据库怎么选型?你们项目用的哪个?
主流选择:Milvus(大规模分布式)、Qdrant(Rust 高性能)、Weaviate(GraphQL 友好)、Elasticsearch(已有 ES 集群就直接用)、Chroma/FAISS(轻量原型验证)。派聪明选了 ES,因为团队本身就熟悉 ES 生态,不需要额外引入新组件。
🟡 进阶 | → 派聪明 ES 8.10 + dense_vector | 字节、快手
85. 向量检索和关键词检索的混合搜索怎么做?
派聪明的 HybridSearchService 先用 KNN 做向量召回,召回窗口是 topK×30;同时用 textContent match 做关键词约束,并叠加 userId、public、orgTag 权限过滤,最后通过 BM25 rescore 做第二阶段排序。纯向量搜索容易漏掉精确关键词,纯关键词又缺语义理解,混合搜索两头都兼顾了。
🟡 进阶 | → 派聪明 HybridSearchService KNN + BM25 | 快手、字节
86. 什么是 Query Rewrite?为什么需要改写用户查询?
用户提问偏口语化、模糊、有歧义。Query Rewrite 把用户原始问题改写成更适合检索的形式,比如补全指令、拆分意图、扩展同义词等。派聪明当前是查询向量化 + KNN/BM25 混合检索,Query Rewrite 可以作为检索增强点继续接入。
🟡 进阶 | → 派聪明可扩展 | 快手、阿里
87. 什么是多路召回?具体怎么做?
同一个查询走多条检索通道(向量召回、关键词召回、知识图谱召回),每条通道返回一批候选,最后合并去重排序。派聪明当前更准确地说是 KNN 召回叠加关键词约束和 BM25 rescore,不是完全独立的多路召回;后续可以扩展成向量、关键词、知识图谱等多路候选合并。多路召回的核心价值是降低单一路径漏召回的风险。
🟡 进阶 | → 派聪明 KNN + BM25 rescore,可扩展多路召回 | 快手、字节
88. 为什么检索之后还需要 Rerank?
向量检索是“粗筛”,召回量大但排序不够精准。Rerank 可以用交叉编码器对 query 和每个候选文档做精细打分,把最相关的排到前面。派聪明当前采用的是 KNN 召回后再用 BM25 rescore 做第二阶段排序,独立 Rerank 可以作为后续增强。
🟡 进阶 | → 派聪明 KNN 召回 + BM25 rescore | 快手
89. Rerank 的 Top-K 怎么确定?
没有银弹。一般先设一个较大的召回窗口,然后在测试集上逐步缩小,找到精度和延迟的平衡点。K 太大增加排序和上下文拼接成本,K 太小可能漏掉相关文档。派聪明现在的思路是 topK 放大召回窗口,再用 BM25 rescore 精确结果。
🟡 进阶 | → 派聪明召回窗口与 rescore 权重 | 快手
90. RAG 系统怎么评测?核心指标有哪些?
检索阶段看召回率(Recall)、精准率(Precision)、MRR(平均倒数排名)。生成阶段看忠实度(Faithfulness,答案是否基于检索到的内容)、相关性(Relevancy)。RAGAS 框架把这套评测体系标准化了。
🟡 进阶 | → 派聪明 RAG 评测指标 | 快手、Moka
91. 向量数据库里的历史文档怎么做时间衰减?
老文档的信息可能过时了,但向量相似度不会因为时间变化而降低。解决方案:给检索分数乘以一个时间衰减因子(比如指数衰减),或者在索引里加时间字段做过滤。
🟡 进阶 | → 派聪明 ES 元数据过滤可扩展 | 快手
92. 在什么场景下会用图数据库来增强向量检索?
当知识之间有复杂的关联关系时(比如“A 公司收购了 B 公司,B 公司的 CEO 是 C”),纯向量检索很难捕捉这种关系。图数据库(Neo4j、NebulaGraph)擅长处理实体关系查询,和向量检索配合可以回答“C 现在在哪家公司任职”这类需要推理的问题。
🔴 深入 | → 派聪明未来可扩展方向
93. Agentic RAG 和传统 RAG 的核心区别?
传统 RAG 是“检索→生成”的单次流水线。Agentic RAG 给 RAG 加了 Agent 能力,模型可以判断“这次检索结果不够好,换个关键词再搜一次”,或者“这个问题需要先查 A 再查 B 最后综合”。派聪明的 ReAct 循环和 AgentToolRegistry 里的 search_knowledge 工具,就是把知识库检索变成 Agent 可调用工具的实现。
🟡 进阶 | → 派聪明 ReAct + search_knowledge 工具
94. 处理长文档时怎么避免 OOM?
派聪明在 ParseService 里做了两个关键设计:一是流式分块处理,避免一次性把整个文档加载进内存;二是内存阈值保护,运行时内存占用超过 80% 会先触发 GC,复查后仍超阈值才拒绝继续处理。大文件场景下,这比单纯扩大 JVM 堆更稳。
🟡 进阶 | → 派聪明流式处理 + 内存阈值保护
95. RAG 知识库怎么实现动态更新?
文档更新后要同步更新向量索引。派聪明通过 Kafka 异步处理文件上传队列(默认 topic 为 file-processing-topic1),新文档上传后自动触发“解析→分块→向量化→入库”的完整流程,不需要手动重建索引。删除文档时同步清理对应的向量记录。
🟡 进阶 | → 派聪明 Kafka 异步更新
96. 多租户场景下 RAG 的权限隔离怎么做?
派聪明用了三层权限过滤:userId(用户私有文档)、orgTag(组织级隔离)、isPublic(公开标志)。检索时在 ES 查询里加 filter 条件,确保 A 公司的人搜不到 B 公司的文档。这道题在 ToB 方向的公司面试里高频出现。
🟡 进阶 | → 派聪明 userId + orgTag + isPublic 三层过滤
97. 在 RAG 应用中为了优化检索精度,其中的数据清洗和预处理怎么做?
🟡 中等 | AI / 大模型 / RAG | → 派聪明
98. 什么自查询?为什么在 RAG 中需要自查询?
🟢 简单 | AI / 大模型 / RAG | → 派聪明
99. 什么提示压缩?为什么在 RAG 中需要提示压缩?
🟢 简单 | AI / 大模型 / RAG | → 派聪明
100. 在 RAG 中,索引流程中的文档解析你们怎么做的?
🟡 中等 | AI / 大模型 / RAG | → 派聪明
101. 向量数据库中的 HNSW、LSH、PQ 分别是什么意思?
🟡 中等 | AI / 大模型 / RAG / 向量数据库 | → 派聪明
102. 向量数据库中的 ANN 是什么?为什么需要用它?
🟡 中等 | AI / 大模型 / RAG / 向量数据库 | → 派聪明
103. 向量数据库中,常见的向量搜索方法:余弦相似度、欧几里得距离和曼哈顿距离分别是什么?有什么区别?
🟡 中等 | AI / 大模型 / RAG / 向量数据库 | → 派聪明
104. 什么是 Advanced RAG?
🟡 中等 | AI / 大模型 / RAG | → 派聪明
105. 什么是 Modular RAG?
🟡 中等 | AI / 大模型 / RAG | → 派聪明
106. 什么是上下文查询增强?它有什么作用?如何基于 Spring AI 实现上下文查询增强来处理无关问题?
🟡 中等 | 后端 | → 派聪明
107. 什么是 Spring AI 提出的模块化 RAG 架构?预检索、检索和后检索阶段各自负责什么?
🟡 中等 | 后端 | → 派聪明
108. 你有多个知识库,做 RAG 的时候,怎么保证查询效率和准确性兼容,并尽可能减少幻觉?
🟡 中等 | AI / 大模型 / RAG | → 派聪明
109. 如何构建和使用向量索引?HNSW 和 IVF 有什么区别?
🟡 中等 | RAG / 向量索引 | → 派聪明
110. RAG 检索时相似度阈值如何设置?设置不当有什么影响?
🟡 中等 | RAG / 相似度阈值 | → 派聪明
111. RAG 系统如何利用元数据过滤提升检索精度?
🟡 中等 | RAG / 元数据过滤 | → 派聪明
112. 如何处理 RAG 检索不到相关文档的情况?
🟡 中等 | RAG / 检索失败处理 | → 派聪明
113. RAG 系统如何标注信息来源和提供引用?
🟡 中等 | RAG / 引用标注 | → 派聪明
114. RAG 系统在生产环境中如何优化性能和降低成本?
🔴 困难 | RAG / 性能优化 | → 派聪明
115. RAG 系统如何处理 PDF、Word、Markdown 等不同格式文档?
REVIEW 疑似重复 · 待确认:与「Agent 的 RAG 遇到 PDF 怎么办?」内容重合
🟡 中等 | `RAG / 文档处理` | → 派聪明05、LLM 基础与 API(79 题)
聚焦 NLP、Transformer、模型结构、推理机制、API、缓存、Token、结构化输出和模型服务。
116. Responses API 和 Chat Completions API 有什么区别?
NEW 新增题目
Responses API 面向多轮、工具和多模态任务提供统一响应模型,Chat Completions 更接近传统消息数组式对话接口。
完整答案:查看图文解析](https://www.bilibili.com/video/BV11H8n6CEBs/)
117. 大模型 API 缓存命中和未命中为什么差价巨大?
NEW 新增题目
缓存命中可以复用前缀计算与 KV Cache,减少 Prefill 的计算和显存读写,因此延迟与输入成本通常显著下降。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1WAuZ6fEXP/)
118. KV Cache 是什么?为什么只缓存 K 和 V,不缓存 Q?
NEW 新增题目
大模型自回归生成时,每个新 Token 都要和历史 Token 的 K、V 重新做注意力计算,而当前 Token 的 Q 用完即弃,所以只把 K 和 V 存进显存,用空间换时间。
完整答案:查看图文解析
119. Prefix Caching(前缀缓存)是什么?和 KV Cache 是什么关系?
NEW 新增题目
KV Cache 只在单次请求内复用,Prefix Caching 把公共前缀的 KV 数据跨请求共享,靠 Token 分块和 Radix Tree 前缀树匹配。前缀要求从第一个 Token 起逐字匹配,时间戳和用户 ID 放在开头会让整条缓存链失效。
完整答案:查看图文解析
120. DeepSeek 的 Prompt Caching 为什么能全自动生效,Claude 为什么要手动加 cache_control?
NEW 新增题目
DeepSeek 把 KV Cache 落盘到分布式硬盘,按请求结束、公共前缀和固定 Token 间隔三种时机切成前缀单元自动命中;Claude 需要用 cache_control 字段手动标记缓存断点。写 Agent 时把系统提示词和工具定义固定在开头,动态内容放末尾。
完整答案:查看图文解析
121. MoE 是什么?DeepSeek 模型为什么采用混合专家架构?
NEW 新增题目
MoE 每次只激活部分专家网络,在控制单次计算量的同时扩大模型总容量,但需要解决路由、负载均衡和通信问题。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1EKuJ6VEkc/)
122. 什么是线性注意力?GLM-5.3-Flash 为什么采用线性注意力加稀疏注意力的混合架构?
NEW 新增题目
线性注意力把计算量从 O(n²) 降到 O(n),但会损失精确检索能力,GLM-5.3-Flash 用稀疏注意力补回这部分损失,在长上下文下拿到低成本推理。
完整答案:查看图文解析
123. SWE-bench、Terminal-Bench、GPQA Diamond 这些大模型评测集到底在测什么?
NEW 新增题目
主流评测集按能力分三类:SWE-bench 系列考修 bug,Terminal-Bench 和 MCP-Atlas 考工具调用,GPQA Diamond 考博士级推理。选模型要看和自己场景匹配的分项,不看总分。
完整答案:查看图文解析
124. 什么是大语言模型?和传统 NLP 模型有什么区别?
传统 NLP 模型(LSTM、CRF)针对特定任务训练,换任务就得重新训练。大语言模型通过海量数据预训练获得通用语言能力,一个模型能处理翻译、摘要、问答、代码生成等各种任务,靠 Prompt 引导就行。
🟢 基础
125. 讲讲 Transformer 的基本架构?Encoder 和 Decoder 分别干什么?
Encoder 负责理解输入(把文本编码成语义向量),Decoder 负责生成输出(基于语义向量逐 token 生成文本)。GPT 系列只用 Decoder,BERT 只用 Encoder,T5 用完整的 Encoder-Decoder。现在主流的大语言模型基本都是 Decoder-only 架构。
🟢 基础 | 字节、腾讯
126. 多头注意力(MHA)有哪些局限?MQA、GQA、Flash Attention 怎么解决?
MHA 每个头都有独立的 KV 矩阵,显存占用大。MQA(Multi-Query Attention)所有头共享一组 KV,省显存但效果有损。GQA(Grouped-Query Attention)折中方案,几个头共享一组 KV。Flash Attention 从计算层面优化,减少 HBM 访问次数,不改注意力机制本身。
🟡 进阶 | 字节、腾讯
127. 位置编码是干什么用的?RoPE 和 ALiBi 有什么区别?
Transformer 本身不感知 token 顺序,位置编码告诉模型“第几个词在第几个位置”。RoPE(旋转位置编码)通过旋转矩阵编码相对位置,外推性好。ALiBi 直接在注意力分数上加一个和距离相关的偏置,实现简单,不需要额外参数。
🟡 进阶
128. 分词器是什么?BPE、WordPiece、SentencePiece 有什么区别?
分词器把文本拆成 token(模型能理解的最小单位)。BPE(字节对编码)从字符出发逐步合并高频对,GPT 系列在用。WordPiece 类似 BPE 但用似然概率选合并对,BERT 在用。SentencePiece 直接在原始文本上训练,不依赖预分词,多语言友好。
🟡 进阶
129. 什么是 Scaling Law?大模型的涌现能力是怎么回事?
Scaling Law 说的是模型性能随参数量、数据量、算力的增加呈可预测的幂律关系。涌现能力是指模型规模达到某个阈值后突然出现的能力(比如思维链推理),小模型完全不会,大模型突然就会了。
🟡 进阶
130. 大模型生成文本时有哪些解码策略?
贪心搜索(每步选概率最高的 token,确定性强但无聊)、束搜索(保留 top-k 条候选路径)、温度采样(temperature 控制随机性)、Top-P 采样(nucleus sampling,动态截断低概率 token)、Top-K 采样(只从前 K 个 token 里采样)。
🟡 进阶
131. Temperature、Top-P、Top-K 分别是什么?怎么调?
Temperature 控制概率分布的“平滑度”(低→保守,高→发散),Top-P 控制累积概率阈值,Top-K 控制候选集大小。代码生成建议低 temperature(0.1-0.3),创意写作用高 temperature(0.7-1.0)。PaiAgent 的 ChatClientFactory 默认 temperature=0.7。
🟡 进阶 | → PaiAgent ChatClientFactory temperature 配置
132. 大模型幻觉问题怎么减少?
RAG 是最有效的方案之一,让模型基于检索到的真实文档回答,而不是“自由发挥”。派聪明用 generationId 关联 referenceMappings,并在 ChatGenerationStateService / ConversationService 中保存引用详情,前端可以点击“来源”回看命中的 chunk。其他手段还有降低 temperature、增加 system prompt 约束、让模型说“我不确定”。
🟡 进阶 | → 派聪明 generationId + referenceMappings 引用追踪 | 阿里云、京东、蚂蚁
133. 什么是 CoT(思维链)?为什么效果好?有什么局限?
CoT 让模型“一步步想”而不是直接给答案,把推理过程显式化。效果好是因为把复杂问题分解成了多个简单步骤。局限是增加了 token 消耗和延迟,而且模型可能生成“看起来合理但实际错误”的推理链。
🟡 进阶
134. 多模型动态切换怎么实现?不重启服务就能换?
PaiAgent 的 ChatClientFactory 每次调用都 new 一个新的 ChatClient,不用 Spring 单例。每个节点可以配不同的 apiUrl 和 model,第一个节点用 DeepSeek 做初步分析,第二个节点用 GPT 做精细加工,改个配置下次执行就生效。
🟡 进阶 | → PaiAgent ChatClientFactory 动态工厂 | Shopee、腾讯、Moka
135. OpenAI 兼容协议是什么?各家大模型的差异在哪?
请求格式统一走 /v1/chat/completions,差异在 base_url 和 api_key。响应大部分字段一致,个别细节不同,比如 token 统计有的叫 prompt_tokens 有的叫 input_tokens。PaiAgent 用 Spring AI 的 OpenAiChatModel 统一了 OpenAI、DeepSeek、通义千问三家的接入。
🟡 进阶 | → PaiAgent OpenAiApi 统一多厂商
136. 流式输出(SSE / WebSocket)怎么设计?
派聪明用 WebSocket 做长连接,结合 DeepSeek 流式接口实现“打字机效果”,模型每生成一个 token 就推送给前端。还支持用户主动停止生成。技术细节包括心跳保活、断线重连、背压处理。
🟡 进阶 | → 派聪明 WebSocket + DeepSeek 流式接口 | 快手
137. 对比使用过哪些主流大模型?你们项目里最终选了哪个?
PaiAgent 支持 OpenAI、DeepSeek、通义千问、智谱四家。PaiCLI 接了 GLM、DeepSeek V4、Kimi、StepFun 等。选型原则:代码生成优先 DeepSeek/Claude,中文对话优先通义千问/GLM,性价比优先 DeepSeek。没有最好的模型,只有最适合场景的模型。
🟡 进阶 | → PaiAgent 四家模型 / PaiCLI 多模型适配 | Shopee、腾讯
138. 怎么让 LLM 返回结构化内容,比如和 Java 对象字段一一对应?
NEW 新增题目
Spring AI 可以通过 .entity() 将模型输出映射为 Java 对象;生产环境还需要配合 Schema 约束、字段校验和失败重试。
完整答案:待更新
139. LLM 返回的内容被截断了怎么办?
NEW 新增题目
先检查输出 Token 上限与 finish_reason,再根据场景选择提高上限、缩短上下文、分段生成或续写,并对最终结果做完整性校验。
完整答案:待更新
140. 什么是词嵌入(Word Embedding)?有哪些常见的词嵌入方法?
🟡 中等 | 自然语言处理(NLP) / 词嵌入 / Word2Vec | → PaiCLI / PaiAgent 大模型应用基础
141. 是否使用 Word2Vec 训练过数据?在这个过程中,如何获取语料?如何选择超参数?语料、词表和维度大小如何确定?怎样把握训练时长?
🔴 困难 | 自然语言处理(NLP) / 词嵌入 / Word2Vec | → PaiCLI / PaiAgent 大模型应用基础
142. Word2Vec 有哪些加速方法?
🔴 困难 | 自然语言处理(NLP) / 词嵌入 / Word2Vec | → PaiCLI / PaiAgent 大模型应用基础
143. 解释 hierarchical softmax 的流程,以及它有什么优点?
🔴 困难 | 自然语言处理(NLP) / 词嵌入 / Word2Vec / hierarchical softmax | → PaiCLI / PaiAgent 大模型应用基础
144. 说一说负采样技术在 Word2Vec 中的运用。
🟡 中等 | 自然语言处理(NLP) / 词嵌入 / Word2Vec / 负采样 | → PaiCLI / PaiAgent 大模型应用基础
145. CBOW 和 Skip-gram 分别更适合哪些应用场景?
🟡 中等 | 自然语言处理(NLP) / CBOW / Skip-gram | → PaiCLI / PaiAgent 大模型应用基础
146. 说说 GloVE 技术,怎样进行训练?有哪些应用场景?相比 Word2Vec 有哪些优缺点?
🔴 困难 | 自然语言处理(NLP) / Word2Vec / GloVE | → PaiCLI / PaiAgent 大模型应用基础
147. 说说 FastText 技术,是否比 Word2Vec 更优越?哪些情况下更适合使用 FastText
🔴 困难 | 自然语言处理(NLP) / Word2Vec / FastText | → PaiCLI / PaiAgent 大模型应用基础
148. 聊一聊 ELMo 技术,它有哪些优缺点?可以做到一词多义吗?为什么?
🔴 困难 | 自然语言处理(NLP) / ELMo | → PaiCLI / PaiAgent 大模型应用基础
149. 说说 LSTM 的基本原理。
🟢 简单 | 自然语言处理(NLP) / LSTM | → PaiCLI / PaiAgent 大模型应用基础
150. 与循环神经网络(RNN)相比,LSTM 是如何解决梯度消失问题的?
🟡 中等 | 自然语言处理(NLP) / LSTM / RNN / 梯度消失 | → PaiCLI / PaiAgent 大模型应用基础
151. 解释一个 LSTM 单元(LSTM cell)的基本组成,以及它们各自的作用。
🟡 中等 | 自然语言处理(NLP) / LSTM | → PaiCLI / PaiAgent 大模型应用基础
152. LSTM 中,隐藏状态(hidden state)和单元状态(cell state)有什么区别?
🟡 中等 | 自然语言处理(NLP) / LSTM | → PaiCLI / PaiAgent 大模型应用基础
153. LSTM 和 GRU 有什么区别?
🟡 中等 | 自然语言处理(NLP) / LSTM / GRU | → PaiCLI / PaiAgent 大模型应用基础
154. 请描述 BERT 模型的架构和应用场景。
🟡 中等 | 自然语言处理(NLP) / BERT | → PaiCLI / PaiAgent 大模型应用基础
155. BERT 是如何处理自然语言文本中不常见词或者罕见词的?
🟡 中等 | 自然语言处理(NLP) / BERT | → PaiCLI / PaiAgent 大模型应用基础
156. Word2Vec 到 BERT 有怎样的改进?
🟡 中等 | 自然语言处理(NLP) / BERT / Word2Vec | → PaiCLI / PaiAgent 大模型应用基础
157. BERT 怎样进行 mask 相比 CBOW 有什么区别?
🟡 中等 | 自然语言处理(NLP) / BERT / CBOW | → PaiCLI / PaiAgent 大模型应用基础
158. 你有什么办法可以比较好地解决 BERT 输入长度的限制?
🔴 困难 | 自然语言处理(NLP) / BERT | → PaiCLI / PaiAgent 大模型应用基础
159. 说说你是怎样有效地优化和微调 BERT,以应对你做过的一些特定的 NLP 任务的?
🔴 困难 | 自然语言处理(NLP) / BERT | → PaiCLI / PaiAgent 大模型应用基础
160. 如何比较文本的相似度?
🟢 简单 | 自然语言处理(NLP) / 文本分类 | → PaiCLI / PaiAgent 大模型应用基础
161. 支持向量机可以用于文本分类任务吗?若可以,请说明。
🟢 简单 | 自然语言处理(NLP) / 文本分类 / 支持向量机 | → PaiCLI / PaiAgent 大模型应用基础
162. 在文本分类任务中,如何处理高维和稀疏数据?
🟡 中等 | 自然语言处理(NLP) / 文本分类 | → PaiCLI / PaiAgent 大模型应用基础
163. 在文本分类任务中,如何处理样本(类别)不平衡的问题?
🟡 中等 | 自然语言处理(NLP) / 文本分类 | → PaiCLI / PaiAgent 大模型应用基础
164. 现有文本分类算法在处理多语种文本数据时可能遭遇哪些挑战?
🟡 中等 | 自然语言处理(NLP) / 文本分类 | → PaiCLI / PaiAgent 大模型应用基础
165. 简述 Word Embedding 可以怎样运用于文本分类任务?
🟡 中等 | 自然语言处理(NLP) / 文本分类 / Word Embedding | → PaiCLI / PaiAgent 大模型应用基础
166. 简述 LLaMA(Large Language Model Meta AI)的基本原理。
🟡 中等 | 自然语言处理(NLP) / 大语言模型 | → PaiCLI / PaiAgent 大模型应用基础
167. LLaMA 有哪些实际应用?
🟢 简单 | 自然语言处理(NLP) / 大语言模型 | → PaiCLI / PaiAgent 大模型应用基础
168. Transformer 在计算 attention 的时候使用的是点乘还是加法?请说明理由。
🟡 中等 | Transformer | → PaiAgent / PaiCLI 模型选型背景
169. self attention 中的 K 和 Q 是用来做什么的?
🟢 简单 | Transformer / 自注意力机制 | → PaiAgent / PaiCLI 模型选型背景
170. K 和 Q 可以使用同一个值通过对自身进行点乘得到吗?
🟡 中等 | Transformer | → PaiAgent / PaiCLI 模型选型背景
171. 如果让 K 和 Q 变成同一个矩阵,你觉得对模型性能会带来怎样的影响?
🔴 困难 | Transformer | → PaiAgent / PaiCLI 模型选型背景
172. 在不考虑计算量的情况下,head 能否无限增多?
🟡 中等 | Transformer / 多头注意力机制 | → PaiAgent / PaiCLI 模型选型背景
173. 在进行多头注意力的时候需要对每个 head 进行降维吗?
🟡 中等 | Transformer / 多头注意力机制 | → PaiAgent / PaiCLI 模型选型背景
174. 讲一下你对 Transformer 的 Encoder 模块的理解。
🟡 中等 | Transformer / Encoder | → PaiAgent / PaiCLI 模型选型背景
175. Transformer 中,Decoder 阶段的多头自注意力和 Encoder 阶段的多头自注意力是相同的吗?
🟡 中等 | Transformer / Encoder / Decoder / 多头自注意力机制 | → PaiAgent / PaiCLI 模型选型背景
176. 了解 Transformer 模型训练中的梯度裁剪(Gradient Clipping)吗?
🟡 中等 | Transformer / 梯度裁剪 | → PaiAgent / PaiCLI 模型选型背景
177. Transformer 为什么采用 Layer Normalization 而不是 Batch Normalization
🟡 中等 | Transformer / normalization | → PaiAgent / PaiCLI 模型选型背景
178. Transformer 中的注意力遮蔽(Attention Masking)的工作原理是什么?
🟡 中等 | Transformer / 注意力遮蔽 | → PaiAgent / PaiCLI 模型选型背景
179. 什么是自回归属性(autoregressive property)?
🟡 中等 | Transformer / 自回归属性 | → PaiAgent / PaiCLI 模型选型背景
180. Transformer 中的“残差连接”可以缓解梯度消失问题吗?
🟡 中等 | Transformer / 残差连接 / 梯度消失 | → PaiAgent / PaiCLI 模型选型背景
181. Transformer 中,如何处理大型数据集?
🟡 中等 | Transformer | → PaiAgent / PaiCLI 模型选型背景
182. Transformer 模型训练完成后,如何评估其性能和效果?
🟡 中等 | Transformer | → PaiAgent / PaiCLI 模型选型背景
183. Transformer 模型的性能瓶颈在哪?
🟡 中等 | Transformer | → PaiAgent / PaiCLI 模型选型背景
184. 你觉得可以怎样缓解这个性能瓶颈?
🔴 困难 | Transformer | → PaiAgent / PaiCLI 模型选型背景
185. 了解 ViT(Vision Transformer) 吗?
🟡 中等 | Vision Transformer | → PaiAgent / PaiCLI 模型选型背景
186. 了解 ViLT(Vision-and-Language Transformer) 吗?
🔴 困难 | ViLT | → PaiAgent / PaiCLI 模型选型背景
187. ViLT 模型是如何将 Transformer 应用于图像识别任务的
🟡 中等 | ViLT / 图像识别 | → PaiAgent / PaiCLI 模型选型背景
188. chatGLM 和 GPT 在结构上有什么区别?
🟡 中等 | Transformer / 语言模型 | → PaiAgent / PaiCLI 模型选型背景
189. 什么是 GPT Structured Outputs?
🟢 简单 | AI / 大模型 | → PaiAgent / PaiCLI
190. 什么是 GPTCache?
🟢 简单 | AI / 大模型 | → PaiCLI / PaiAgent
191. 大模型的 Token 是什么?输入 Token 和输出 Token 在计费上有什么区别?
🟢 简单 | 大模型 / Token / 计费模型 | → PaiCLI / PaiAgent
192. MoE 混合专家模型是什么?DeepSeek、Qwen 为什么用 MoE?
REVIEW 疑似重复 · 待确认:与「MoE 是什么?DeepSeek 模型为什么采用混合专家架构?」内容重合
MoE 把一个大模型拆成多个“专家”子网络,每次推理只激活其中几个专家。好处是模型总参数量大(知识储备多),但每次推理的计算量小(只用部分专家)。DeepSeek V3 用的就是 MoE,671B 总参数但每次只激活 37B。🟡 进阶
193. 什么是 Token 缓存机制?它如何帮助降低 AI 应用的成本?
REVIEW 疑似重复 · 待确认:与「大模型 API 缓存命中和未命中为什么差价巨大?」内容重合
🟢 简单 | `大模型 / Token 缓存 / 成本优化` | → PaiCLI / PaiAgent194. KV Cache 是什么?Prompt Caching 又是什么?
REVIEW 疑似重复 · 待确认:与「KV Cache 是什么?为什么只缓存 K 和 V,不缓存 Q?」「DeepSeek 的 Prompt Caching 为什么能全自动生效」内容重合
KV Cache 缓存已计算的 Key/Value 矩阵,避免每生成一个新 token 都重新算前面所有 token 的注意力。Prompt Caching 更上一层,缓存相同前缀 Prompt 的计算结果,多次请求共享同一份缓存。PaiCLI 支持 Prompt Cache 可视化,让用户看到缓存命中率。🟡 进阶 | → PaiCLI Prompt Cache 可视化
06、Claude Code与Codex(17 题)
聚焦 Claude Code、Codex 及其背后的代码理解、上下文管理、诊断、审查、回滚和自动修复能力。
195. Claude Code 的短期记忆是怎么实现的?
NEW 新增题目
完整答案:查看图文解析](https://www.bilibili.com/video/BV1XrK16YEWe/)
196. Claude Code 的长期记忆是怎么实现的?
NEW 新增题目
完整答案:查看图文解析](https://www.bilibili.com/video/BV18wGN68E3Q/)
197. Claude Code 如何检索长期记忆?
NEW 新增题目
完整答案:查看图文解析](https://www.bilibili.com/video/BV1C8gH6tE5B/)
198. CLAUDE.md 到底要怎么写才有用?
NEW 新增题目
完整答案:查看图文解析](https://www.bilibili.com/video/BV1Z13X6rEk5/)
199. Codex 的短期记忆是怎么实现的?
NEW 新增题目
完整答案:查看图文解析](https://www.bilibili.com/video/BV1QnKY6bELM/)
200. Codex 的长期记忆是怎么实现的?
NEW 新增题目
完整答案:查看图文解析
201. AI 辅助编程在实际工作中怎么提效的?
这道题考的不是技术深度,而是真实使用经验。PaiCLI 在日常开发中能做到:自然语言描述需求 → 自动生成代码 → 编译检查 → 自动修复错误 → 提交 Git。关键不在于代码生成准确率有多高,而在于“生成→反馈→修正”的循环效率。
🟡 进阶 | → PaiCLI 日常开发全流程 | 小红书、蚂蚁、影石
202. 代码生成场景下 AST 分析有什么用?
AST(抽象语法树)能让 Agent 理解代码的结构而不只是文本。PaiCLI 集成了 JavaParser 做 AST 分析,可以精确定位类、方法、字段的位置和关系,比正则匹配靠谱得多。生成代码时能确保插入位置正确、不破坏已有的代码结构。
🟡 进阶 | → PaiCLI JavaParser AST 分析
203. LSP 诊断注入在 AI Coding 中解决什么问题?
LSP(Language Server Protocol)能提供实时的编译错误、类型检查、未使用变量等诊断信息。PaiCLI 把 LSP 诊断信息注入到 Agent 的上下文里,让模型在生成和修改代码时能“看到”IDE 级别的错误提示,修复准确率大幅提升。
🟡 进阶 | → PaiCLI LSP 诊断注入
204. 怎么保障 AI 改代码的安全性?Git 快照回滚怎么做?
AI 改错代码是常有的事,关键是能快速恢复。PaiCLI 实现了 Git Side-History 机制,每次 AI 修改前自动创建快照,改坏了一键回滚到修改前的状态。类似游戏里的存档读档,心理负担一下子就没了。
🟡 进阶 | → PaiCLI Git Side-History 快照回滚
205. 代码库的向量化和语义搜索怎么做?
把代码文件按函数/类切块,生成向量存入数据库,搜索时用自然语言描述找到语义最匹配的代码片段。PaiCLI 用 SQLite 做代码向量的持久化存储,还构建了代码关系图谱,能理解函数之间的调用关系。
🟡 进阶 | → PaiCLI SQLite 向量存储 + 代码关系图谱
206. AI 代码审查和人工代码审查有什么互补关系?
AI 审查擅长的是:风格一致性检查、常见 bug 模式识别、安全漏洞扫描、代码复杂度评估。人工审查擅长的是:业务逻辑正确性、架构合理性、可维护性判断。最佳实践是 AI 先过一轮自动审查,人工只关注 AI 标记出来的问题和业务逻辑。
🟡 进阶
207. 多文件编辑时上下文怎么管理?
AI 改一个功能可能涉及 5-10 个文件,全部塞进上下文 token 就炸了。PaiCLI 的做法是:先用 Glob/Grep 精准定位相关文件和代码段,只把必要的片段加入上下文,改完一个文件就释放那部分上下文。代码关系图谱在这里也能帮忙,自动找出“改了 A 文件,B、C 文件也需要同步改”。
🟡 进阶 | → PaiCLI Glob/Grep + 代码关系图谱
208. CLI 形态的 AI Agent 和 IDE 插件形态有什么优劣?
CLI 形态(PaiCLI、Claude Code):不依赖特定 IDE,跨平台通用,适合全栈开发和 DevOps 场景,但缺少 GUI 交互。IDE 插件形态(GitHub Copilot、通义灵码):和编辑器深度集成,补全体验好,但绑定特定 IDE。PaiCLI 选 CLI 是因为 Java 开发者用的 IDE 太分散了,IntelliJ、Eclipse、VS Code 都有人用。
🟡 进阶 | → PaiCLI CLI 形态设计考量
209. 什么是 Agentic Engineering?它和 Vibe Coding 有什么区别?
🟢 简单 | AI Coding / Agentic Engineering / Vibe Coding | → PaiCLI / PaiAgent
210. 什么是深度思考(Deep Thinking)和自适应思考(Adaptive Thinking)?它们在 AI 编程中有什么应用?
🟢 简单 | AI Coding / Deep Thinking / Adaptive Thinking | → PaiCLI / PaiAgent
211. 什么是 Background Agent(后台 Agent)?它改变了 AI 编程的什么工作方式?
🟢 简单 | AI Coding / Background Agent / 异步任务 | → PaiCLI / PaiAgent
07、DeepSeek专题(5 题)
聚焦 DeepSeek 的后训练、注意力结构、缓存机制、多模态与 Harness 插件系统。
212. 为什么更小的激活参数也能获得更强 Agent 能力?
NEW 新增题目
Agent 能力不只取决于激活参数规模,后训练数据、工具使用训练、推理策略和运行时适配同样会显著影响效果。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1K7uF6PEKD/)
213. CSA、HCA 与 KV Cache:DeepSeek V4 缓存为什么更便宜?
NEW 新增题目
缓存命中不仅跳过 Prefill,还能复用注意力相关中间状态;CSA 与 HCA 的设计重点之一就是降低长上下文推理开销。
完整答案:查看图文解析
214. DeepSeek V4 为什么用 CSA 和 HCA 替换 MLA?
NEW 新增题目
注意力结构的取舍要同时考虑训练效果、长上下文、缓存占用与推理吞吐,CSA 和 HCA 针对这些目标重新平衡。
完整答案:查看图文解析
215. Cordis 是什么?DeepSeek Harness 的插件系统如何理解?
NEW 新增题目
Cordis 通过依赖注入、生命周期和服务注册组织可扩展能力,是理解 DeepSeek Harness 插件架构的重要入口。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1h1bY6QEWF/)
216. 多模态模型和纯文本模型有什么区别?以 DeepSeek V4-Flash-Vision-Exp 为例
NEW 新增题目
多模态模型通过视觉编码器把图片翻译成 Token,和文本共用同一个入口,从而解锁看图识物、截图转代码这些纯文本模型做不到的场景。
完整答案:查看图文解析
热点解读(2 题)
模型发布和行业事件的快速拆解,面试聊到最新动态时用得上。
GPT-6 Astra 全量上线,为什么 OpenAI 敢说 AGI 时代来了?
GPT-6 Astra 在 ARC-AGI-3 上拿到 99.9%,靠的是紧凑符号世界模型加有状态的 Harness。它能直接操作电脑,网络安全等级首次达到 Critical。模型越强,Harness 的设计就越关键。
完整内容:查看图文解析
Claude、ChatGPT、Grok 全崩,你的中转为什么还能用?
官网和 API 共用 Cloudflare 做流量入口,入口挂了就全挂。中转还能跑,是因为 OpenAI 兼容协议让切换模型零成本,而各家模型的能力和风格已经趋同到难以分辨。文中给了三个验证中转到底在调谁的方法。
完整内容:查看图文解析
08、Prompt 工程(14 题)
聚焦系统提示词、Few-shot、自洽性、提示词评测、注入防护,以及 Prompt Engineering 的实践方法。
217. 什么是提示词工程(Prompt Engineering)?
NEW 新增题目
提示词工程通过角色、目标、约束、示例和输出格式提高单次模型响应质量,但不能单独解决动态上下文与运行时控制问题。
完整答案:查看图文解析](https://www.bilibili.com/video/BV1zhNE6aEGH/)
218. 提示词中的分隔符有什么作用?如何使用?
🟢 简单 | Prompt / 分隔符 | → PaiCLI / PaiAgent
219. 什么是系统提示词 System Prompt?它和用户提示词有什么区别?
🟢 简单 | Prompt / System Prompt | → PaiCLI / PaiAgent
220. 什么是 Few-shot Learning?Zero-shot、One-shot、Few-shot 有什么区别?
🟡 中等 | Prompt / Few-shot Learning | → PaiCLI / PaiAgent
221. 如何选择和设计 Few-shot 示例以提升效果?
🟡 中等 | Prompt / Few-shot 示例设计 | → PaiCLI / PaiAgent
222. 什么是自洽性?如何应用?
🟡 中等 | Prompt / 自洽性 | → PaiCLI / PaiAgent
223. 什么是负面提示词?在什么场景下使用?
🟡 中等 | Prompt / 负面提示词 | → PaiCLI / PaiAgent
224. 什么是提示词链接?如何实现?
🟡 中等 | Prompt / 提示词链接 | → PaiCLI / PaiAgent
225. 如何为不同领域设计专用提示词?比如编程、创作、数据分析
🟡 中等 | Prompt / 领域专用提示词 | → PaiCLI / PaiAgent
226. 如何系统地评估和优化提示词的效果?
🔴 困难 | Prompt / 效果评估 | → PaiCLI / PaiAgent
227. 提示词注入攻击是什么?如何防范?
🔴 困难 | Prompt / 安全防护 | → PaiCLI / PaiAgent
228. 在实际项目中如何进行提示词的 AB 测试和迭代?
🔴 困难 | Prompt / A/B 测试 | → PaiCLI / PaiAgent
229. 什么是思维树 Tree of Thoughts?它相比 CoT 有什么优势?
🔴 困难 | Prompt / 思维树 | → PaiCLI / PaiAgent
230. 如何写好 Prompt?分享下 Prompt 工程的实践经验?
REVIEW 疑似重复 · 待确认:与「什么是提示词工程(Prompt Engineering)?」内容重合
核心原则:角色设定(“你是一个资深Java工程师”)、明确任务(具体描述要做什么)、输出格式约束(JSON/Markdown)、Few-shot 示例(给几个例子)、约束条件(不要做什么)。PaiCLI 做了一套 Prompt 分层设计,从系统级到 Skill 级,层级越高优先级越高。🟡 进阶 | → PaiCLI Prompt 分层覆盖机制
09、MCP 与工具调用(21 题)
聚焦 Function Calling、Tool Calling、MCP、A2A、ACP、工具 Schema、权限与协议适配。
231. Function Calling 底层是怎么实现的?
模型在训练阶段见过大量“函数描述→调用参数”的样本,推理时根据用户意图生成结构化的函数调用 JSON。PaiAgent 里每个工具通过 Spring AI 的 FunctionCallback 接口注册,getName/getDescription/getInputTypeSchema 三件套就是 Function Calling 的标准协议。
🟡 进阶 | → PaiAgent FunctionCallback 实现 | 字节、阿里
232. LLM 是如何学会调用外部工具的?Function Call 能力怎么训练?
两种路径:一是在 SFT 阶段用大量“用户问题→工具调用→工具返回→最终回答”的样本做微调;二是在 Prompt 里描述工具并给 Few-shot 示例,利用 In-Context Learning 能力。前者效果更稳定,后者不需要重新训练。GPT 系列走的是第一条路。
🟡 进阶
233. MCP 是什么?它解决了什么问题?
MCP 是一套标准化的“模型↔工具”通信协议,让 AI 应用能像 USB 一样即插即用地接入各种外部工具。之前每接一个工具就要写一套适配代码,有了 MCP,工具提供方按协议封装一次,所有支持 MCP 的 Agent 都能直接用。
🟡 进阶 | → PaiCLI MCP 集成 / PaiAgent MCP 工具配置 | 腾讯、蚂蚁、字节
234. MCP 由哪几部分组成?
三大组件:MCP Server(提供工具/资源的服务端)、MCP Client(Agent 侧的客户端,发起调用)、协议规范(定义工具描述格式、请求响应格式、传输方式)。PaiCLI 里同时实现了 Client 端(调用外部 MCP Server)和对协议的完整支持。
🟡 进阶 | → PaiCLI MCP Client 实现
235. MCP 和 Function Calling 有什么区别?
Function Calling 是模型层面的能力,模型决定调用什么函数、传什么参数。MCP 是传输层的协议,规定了工具怎么描述自己、怎么接收调用、怎么返回结果。可以理解为 Function Calling 是“大脑的决策”,MCP 是“手脚的执行通道”。
🟡 进阶 | → PaiAgent(Function Calling)+ PaiCLI(MCP 传输) | 作业帮、腾讯
236. Function Calling、Skill、MCP 三者有什么区别?
FC 是模型决策层(决定调什么工具),MCP 是传输层(工具怎么通信),Skill 是知识层(预置的最佳实践指南)。三者不互斥,一次完整的工具调用可能同时涉及:Skill 告诉模型“这个场景该用搜索工具”,模型通过 FC 生成调用参数,MCP 把请求发给搜索服务。
🟡 进阶 | → PaiAgent(FC + Skill)+ PaiCLI(FC + MCP + Skill)
237. MCP Server 的 stdio 和 HTTP 模式分别怎么用?
stdio 模式通过子进程通信,适合本地工具(文件操作、Git 命令等),延迟低但只能单机。HTTP 模式走网络请求,适合远程服务(数据库、第三方 API),支持分布式但有网络开销。PaiCLI 两种都支持,还能自动发现和注册 MCP Server 的工具列表。
🟡 进阶 | → PaiCLI stdio + HTTP 双模式
238. 为什么有些推理模型不支持 MCP?
推理模型(比如 o1、DeepSeek-R1)在设计时优化了长链推理能力,但牺牲了工具调用能力。它们的训练数据和 RLHF 流程侧重于“想清楚再回答”而不是“边调工具边回答”。解决方案是用推理模型做规划,再用普通模型执行工具调用。
🟡 进阶
239. 什么是 A2A 协议?和 MCP 有什么区别?
A2A(Agent-to-Agent)是 Google 提出的 Agent 间通信协议,解决的是“Agent 和 Agent 怎么对话”的问题。MCP 解决的是“Agent 和工具怎么通信”。一个是 Agent 间的横向协作,一个是 Agent 向下调用工具。
🟡 进阶
240. WebSocket 和 SSE 通信有什么区别?在 AI 场景中各自怎么用?
SSE 是单向的(服务端→客户端),适合模型流式输出。WebSocket 是双向的,适合需要客户端随时发消息的场景(比如中途打断生成)。派聪明用 WebSocket 就是因为需要支持用户主动停止生成。
🟡 进阶 | → 派聪明 WebSocket 双向通信
241. 工具描述(Tool Description)怎么写才能让模型准确调用?
关键是写清楚“什么时候该用这个工具”而不只是“这个工具能干什么”。比如 search_code 的描述不该是“搜索代码”,而该是“当需要在代码库中查找特定函数、变量名或代码片段时使用”。PaiAgent 的 FunctionCallback.getDescription() 就遵循这个原则。
🟡 进阶 | → PaiAgent FunctionCallback 描述设计
242. 敏感工具的安全控制怎么做?
PaiCLI 实现了一套完整的安全机制:HITL(Human-in-the-Loop)人工审批,执行高危操作前先问用户同意;路径围栏,限制文件操作只能在项目目录内;命令黑名单,禁止 rm -rf / 这类危险命令;结构化审计日志,每次工具调用都有迹可查。
🟡 进阶 | → PaiCLI HITL + 路径围栏 + 命令黑名单 | 快手
243. 模型编造不存在的工具调用(工具幻觉)怎么防?
两个手段:一是在工具列表里做白名单校验,模型返回的 tool_calls 如果不在已注册列表里就直接拒绝;二是优化工具描述让模型更准确地理解工具边界。PaiAgent 的 NodeExecutorFactory 通过 Map 注册机制天然实现了白名单校验。
🟡 进阶 | → PaiAgent NodeExecutorFactory 白名单 | 淘天
244. 在 Spring AI 框架中如何集成 MCP?
🟢 简单 | 大模型 / AI / MCP / Spring / Spring AI / Java | → PaiAgent(Spring AI)/ PaiCLI(MCP 对照)
245. MCP 协议安全性设计包含哪些层面?
🟢 简单 | 大模型 / AI / MCP / 安全性 | → PaiAgent / PaiCLI
246. 如何将已有的应用转换成 MCP 服务?
🟢 简单 | 大模型 / AI / MCP / 开发实践 | → PaiAgent / PaiCLI
247. 什么是 A2A 协议,它的核心架构及主要组件有哪些?
🟡 中等 | 大模型 / AI / A2A / 系统架构 | → PaiAgent / PaiCLI
248. A2A 协议有哪五大设计原则?
🟡 中等 | 大模型 / AI / A2A / 系统架构 | → PaiAgent / PaiCLI
249. MCP 和 Skills 有什么区别?分别适用于什么场景?
🟢 简单 | AI / 大模型 / Agent / Skills | → PaiAgent / PaiCLI
250. 不同的 LLM Provider 对 Tool Schema 的支持不完全一致,你会怎么处理这种差异?OpenClaw 是怎么做 Schema 适配的?
🟡 中等 | AI / OpenClaw / 大模型应用开发 / AI应用开发 | → PaiAgent / PaiCLI
251. 什么是 ACP 协议?它有哪两个不同的含义?
🟢 简单 | AI Coding / ACP 协议 / Agent 协议 | → PaiCLI / PaiAgent
10、LangChain 与 Spring AI(21 题)
聚焦 LangChain、LangGraph、LlamaIndex、Spring AI 的编排、记忆、检索、工具与结构化输出能力。
252. 什么是 LangGraph ?
🟢 简单 | AI / 大模型 / LangGraph / 工作流编排 | → PaiAgent
253. LangGraph 编排的原理是什么?
🟢 简单 | AI / 大模型 / LangGraph / 工作流编排 | → PaiAgent
254. LangChain 和 LangGraph 有什么区别?
🟢 简单 | AI / 大模型 / LangGraph / 工作流编排 | → PaiAgent
255. LlamaIndex 如何与 LangChain 结合?
🔴 困难 | 大模型 / AI / Agent / LangChain / LlamaIndex | → PaiAgent 框架选型对比
256. 什么是 Spring AI 框架?它有哪些核心特性?
🟢 简单 | 后端 / Spring AI | → PaiAgent
257. 什么是结构化输出?Spring AI 是怎么实现结构化输出的?
🟡 中等 | 后端 / Spring AI | → PaiAgent
258. 什么是 Re-Reading?如何基于 Spring AI 实现 Re-Reading Advisor?
🟡 中等 | 后端 / Spring AI | → PaiAgent
259. 什么是工具调用 Tool Calling?如何利用 Spring AI 实现工具调用?
🟡 中等 | 后端 / Spring AI | → PaiAgent
260. LangChain 中的 Chain 是什么?有哪些常见类型?
🟢 简单 | LangChain / Chain 链式调用 | → PaiAgent 框架选型对比
261. LangChain 的 Memory 组件有什么作用?常见的 Memory 类型有哪些?
🟡 中等 | LangChain / Memory 记忆机制 | → PaiAgent 框架选型对比
262. 在 LangChain 中如何实现流式输出?
🟡 中等 | LangChain / 流式输出 | → PaiAgent 框架选型对比
263. 如何在 LangChain 中自定义 Tool 工具?
🟡 中等 | LangChain / Tool 工具 | → PaiAgent 框架选型对比
264. LangChain 和 LlamaIndex 有什么区别?各自适合什么场景?
🟡 中等 | LangChain / LlamaIndex / 框架对比 | → PaiAgent 框架选型对比
265. LangChain 中的 DocumentLoader 有哪些类型?如何选择?
🟢 简单 | LangChain / DocumentLoader 文档加载 | → PaiAgent 框架选型对比
266. LangChain 的 OutputParser 有什么作用?有哪些常见类型?
🟢 简单 | LangChain / OutputParser 输出解析 | → PaiAgent 框架选型对比
267. LangChain 中的 Callback 回调机制是什么?有什么用?
🟡 中等 | LangChain / Callback 回调 | → PaiAgent 框架选型对比
268. LangChain 中的 LCEL 表达式语言是什么?有什么优势?
🟡 中等 | LangChain / LCEL | → PaiAgent 框架选型对比
269. LangChain 中如何实现条件分支和动态路由?
🟡 中等 | LangChain / 条件路由 | → PaiAgent 框架选型对比
270. LangChain 中的 Retriever 检索器有哪些类型?各有什么特点?
🟡 中等 | LangChain / Retriever 检索器 | → PaiAgent 框架选型对比
271. 如何处理 LangChain 应用中的错误和异常?
🟡 中等 | LangChain / 异常处理 | → PaiAgent 框架选型对比
272. 如何保证 LangChain 应用的输出质量和一致性?
🔴 困难 | LangChain / 质量保证 | → PaiAgent 框架选型对比
11、模型训练与微调(22 题)
聚焦预训练、SFT、RLHF、DPO、LoRA、PEFT、量化、蒸馏、数据集与训练资源。
273. 大模型是怎么训练出来的?预训练→SFT→RLHF 三阶段讲一下?
预训练(在海量无标注文本上学语言能力)→ SFT(用人工标注的指令-回答对微调,学会“听话”)→ RLHF(用人类偏好反馈做价值观校准,学会“说人话”)。三阶段花费依次降低但重要性递增。
🟡 进阶 | 字节、腾讯
274. 大模型微调有哪些方案?LoRA 的原理是什么?
全量微调(改所有参数,贵)、LoRA(冻结原始权重,只训练低秩分解矩阵,参数量减少 99%+)、QLoRA(量化 + LoRA,更省显存)、Adapter(在层间插入小模块)、Prefix Tuning(只调前缀向量)。LoRA 是目前性价比最高的方案。
🟡 进阶 | 字节、阿里
275. SFT 之后还有哪些 Post-Training?RLHF、DPO、GRPO 什么关系?
SFT 让模型学会格式和基本能力,Post-Training 让模型学会“什么样的回答更好”。RLHF 用奖励模型 + PPO 训练,DPO 去掉奖励模型直接用偏好对训练,GRPO 去掉 Critic 网络用组内相对比较。进化路径是越来越简化训练流程。
🔴 深入 | 作业帮、腾讯
276. DPO 和 PPO 的区别是什么?
PPO 需要先训一个奖励模型,再用奖励模型的分数做策略梯度优化,流程复杂。DPO 直接用偏好数据对(好回答 vs 坏回答)优化策略,把奖励模型隐式地融入到损失函数里,训练更简单稳定。
🔴 深入 | 腾讯、三七互娱
277. 大模型量化是什么?INT8/INT4/AWQ/GPTQ 怎么选?
把模型参数从 FP16 压缩到 INT8/INT4,显存占用直接减半或减四分之三。GPTQ 是训后量化(快但精度损失稍大),AWQ(Activation-aware)考虑激活值分布做量化(精度更好),INT4 省显存最多但精度损失最大。实际选型看你的显卡显存和精度要求。
🟡 进阶
278. 微调中常用的优化器有哪些?
🟡 中等 | 大模型 / AI / 微调 / 优化器 | → PaiAgent / PaiCLI 模型工程面试扩展
279. 微调的过拟合风险如何通过正则化缓解?
🔴 困难 | 大模型 / AI / 微调 | → PaiAgent / PaiCLI 模型工程面试扩展
280. 在多模态微调(如图文生成)中,如何确保文本和图像数据的对齐质量?
🔴 困难 | 大模型 / AI / 微调 / 多模 | → PaiAgent / PaiCLI 模型工程面试扩展
281. 参数高效微调(PEFT)如何减少计算成本?
🔴 困难 | 大模型 / AI / 微调 | → PaiAgent / PaiCLI 模型工程面试扩展
282. 冻结层在微调中的作用是什么?
🔴 困难 | 大模型 / AI / 微调 | → PaiAgent / PaiCLI 模型工程面试扩展
283. 为什么需要混合精度训练?
🔴 困难 | 大模型 / AI / 微调 | → PaiAgent / PaiCLI 模型工程面试扩展
284. 模型输出重复和幻觉如何微调解决?
🔴 困难 | 大模型 / AI / 微调 | → PaiAgent / PaiCLI 模型工程面试扩展
285. 微调大模型需要什么样的硬件?7B 和 70B 模型分别需要多少显存?
🟢 简单 | 大模型 / 微调 / 显存评估 | → PaiAgent / PaiCLI 模型工程面试扩展
286. 2026 年主流的微调工具有哪些?Unsloth、Axolotl、TRL 各有什么特点?
🟢 简单 | 大模型 / 微调工具 / Unsloth / Axolotl / TRL | → PaiAgent / PaiCLI 模型工程面试扩展
287. LoRA 的超参数应该怎么设置?有什么经验法则?
🟢 简单 | 大模型 / LoRA / 超参数 | → PaiAgent / PaiCLI 模型工程面试扩展
288. 对比 LoRA、QLoRA、DoRA 和全量微调,在不同场景下应该如何选择?
🟢 简单 | 大模型 / LoRA / QLoRA / DoRA / 全量微调 | → PaiAgent / PaiCLI 模型工程面试扩展
289. ORPO 是什么?它如何将指令微调和偏好对齐合二为一?
🟢 简单 | 大模型 / ORPO / 偏好对齐 | → PaiAgent / PaiCLI 模型工程面试扩展
290. 如何构建高质量的 SFT 微调数据集?数据质量和数量哪个更重要?
🟢 简单 | 大模型 / SFT / 数据集构建 | → PaiAgent / PaiCLI 模型工程面试扩展
291. 什么是模型蒸馏(Knowledge Distillation)?它和模型量化有什么区别?
🟢 简单 | 大模型 / 模型蒸馏 / 模型量化 | → PaiAgent / PaiCLI 模型工程面试扩展
292. 大模型的训练和推理分别是什么?它们在计算资源需求上有什么区别?
🟢 简单 | 大模型 / 训练 / 推理 / 资源评估 | → PaiAgent / PaiCLI 模型工程面试扩展
293. 什么是大模型的参数量?参数量和模型能力之间是什么关系?
🟢 简单 | 大模型 / 参数量 / 模型能力 | → PaiAgent / PaiCLI 模型工程面试扩展
294. 在多模态微调中,如何确保文本和图像数据的对齐质量?有哪些技术挑战?
REVIEW 疑似重复 · 待确认:与同分类的「如何确保文本和图像数据的对齐质量?」内容重合
🟢 简单 | `大模型 / 多模态微调 / 数据对齐` | → PaiAgent / PaiCLI 模型工程面试扩展ending
做这套题库的时候,我反复在想一个问题,技术更迭这么快,什么样的学习才是不浪费时间的。
Agent 这一轮变化和以往不太一样。以前的技术迭代,学一门新语言、学一个新框架,旧的东西还能用很久。但 Agent 正在改变的是软件的开发方式本身。你写代码的方式、调试的方式、搭建系统的方式,都在被重新定义。这不是「学不学」的问题,而是「早学还是晚学」的问题。
Alan Kay 说过一句话,「预测未来最好的办法就是去创造它」。我觉得这话放在今天特别合适。与其等着被 Agent 浪潮推着走,不如自己先把原理搞透,把项目跑通,把面试里会被问到的每一个点都准备好。
所以我们选择了最笨但最扎实的方式。296 道题,每道题录视频讲,每道题写图文解析,每道题映射到真实项目的真实代码。没有速成,没有捷径,就是一道一道地拆,一个知识点一个知识点地过。
我始终相信一件事,技术的价值不在于它有多新,而在于你是否真正理解它、用过它、能把它讲清楚。这套题库要做的就是帮你到达这个状态。
共勉。