主题
整理自 沉默王二:原文。全文搬运仅供个人学习,请勿外传。
定时任务 ScheduledThreadPoolExecutor 类有两个用途:指定时间延迟后执行任务;周期性重复执行任务。
JDK 1.5 之前,主要使用Timer类来完成定时任务,但是Timer有以下缺陷:
- Timer 是单线程模式;
- 如果在执行任务期间某个 TimerTask 耗时较久,就会影响其它任务的调度;
- Timer 的任务调度是基于绝对时间的,对系统时间敏感;
- Timer 不会捕获执行 TimerTask 时所抛出的异常,由于 Timer 是单线程的,所以一旦出现异常,线程就会终止,其他任务无法执行。
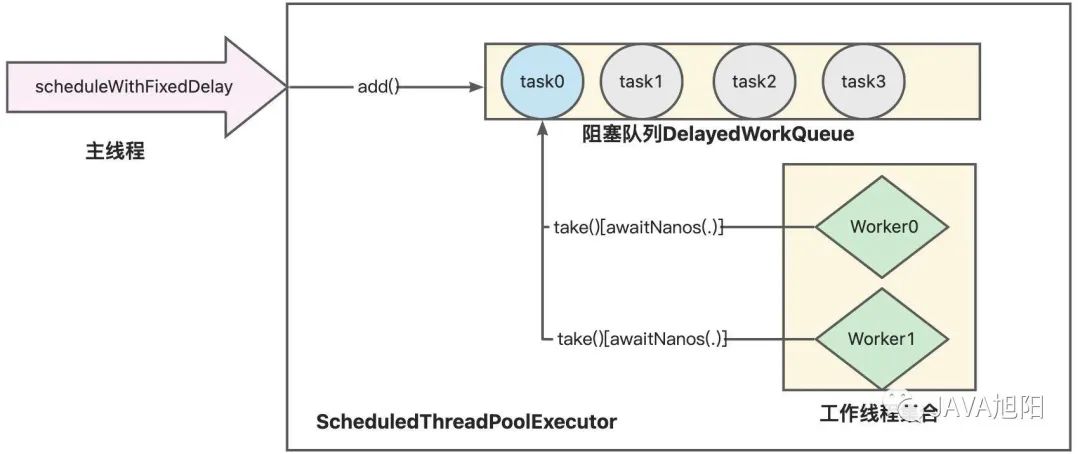
于是 JDK 1.5 之后,开发者就抛弃了 Timer,开始使用ScheduledThreadPoolExecutor。先通过下面这张图感受下。
使用案例
假设我们有这样一个需求,指定时间给其他人发送消息。那么我们会将消息(包含发送时间)存储在数据库中,然后用一个定时任务,每隔 1 秒检查数据库在当前时间有没有需要发送的消息,那这个计划任务怎么完成呢?下面是一个 Demo:
java
public class ThreadPool {

    private static final ScheduledExecutorService executor = new
        ScheduledThreadPoolExecutor(1, Executors.defaultThreadFactory());

    private static SimpleDateFormat df = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss");

    public static void main(String[] args){
        // 新建一个固定延迟时间的计划任务
        executor.scheduleWithFixedDelay(new Runnable() {
            @Override
            public void run() {
                if (haveMsgAtCurrentTime()) {
                    System.out.println(df.format(new Date()));
                    System.out.println("大家注意了,我要发消息了");
                }
            }
        }, 1, 1, TimeUnit.SECONDS);
    }

    public static boolean haveMsgAtCurrentTime(){
        //查询数据库,有没有当前时间需要发送的消息
        //这里省略实现,直接返回true
        return true;
    }
}下面截取一段输出(demo 会一直运行下去):
java
2023-08-24 16:16:48
大家注意了,我要发消息了
2023-08-24 16:16:49
大家注意了,我要发消息了
2023-08-24 16:16:50
大家注意了,我要发消息了
2023-08-24 16:16:51
大家注意了,我要发消息了
2023-08-24 16:16:52
大家注意了,我要发消息了
2023-08-24 16:16:53
大家注意了,我要发消息了
2023-08-24 16:16:54
大家注意了,我要发消息了
2023-08-24 16:16:55
大家注意了,我要发消息了这就是 ScheduledThreadPoolExecutor 的一个简单运用,接下来我们来看看它的实现原理。
类结构
java
public class ScheduledThreadPoolExecutor extends ThreadPoolExecutor
	implements ScheduledExecutorService {

    public ScheduledThreadPoolExecutor(int corePoolSize,ThreadFactory threadFactory) {
         super(corePoolSize, Integer.MAX_VALUE, 0, NANOSECONDS,
              new DelayedWorkQueue(), threadFactory);
    }
    //……
}ScheduledThreadPoolExecutor 继承了ThreadPoolExecutor,并实现了ScheduledExecutorService接口。线程池 ThreadPoolExecutor 在之前介绍过了,相信大家都还有印象,接下来我们来看看 ScheduledExecutorService 接口。
java
public interface ScheduledExecutorService extends ExecutorService {

    /**
     * 安排一个Runnable任务在给定的延迟后执行。
     *
     * @param command 需要执行的任务
     * @param delay 延迟时间
     * @param unit 时间单位
     * @return 可用于提取结果或取消的ScheduledFuture
     */
    public ScheduledFuture<?> schedule(Runnable command, long delay, TimeUnit unit);

    /**
     * 安排一个Callable任务在给定的延迟后执行。
     *
     * @param callable 需要执行的任务
     * @param delay 延迟时间
     * @param unit 时间单位
     * @return 可用于提取结果或取消的ScheduledFuture
     */
    public <V> ScheduledFuture<V> schedule(Callable<V> callable, long delay, TimeUnit unit);

    /**
     * 安排一个Runnable任务在给定的初始延迟后首次执行,随后每个period时间间隔执行一次。
     *
     * @param command 需要执行的任务
     * @param initialDelay 首次执行的初始延迟
     * @param period 连续执行之间的时间间隔
     * @param unit 时间单位
     * @return 可用于提取结果或取消的ScheduledFuture
     */
    public ScheduledFuture<?> scheduleAtFixedRate(Runnable command,
                                                  long initialDelay,
                                                  long period,
                                                  TimeUnit unit);

    /**
     * 安排一个Runnable任务在给定的初始延迟后首次执行,随后每次完成任务后等待指定的延迟再次执行。
     *
     * @param command 需要执行的任务
     * @param initialDelay 首次执行的初始延迟
     * @param delay 每次执行结束后的延迟时间
     * @param unit 时间单位
     * @return 可用于提取结果或取消的ScheduledFuture
     */
    public ScheduledFuture<?> scheduleWithFixedDelay(Runnable command,
                                                     long initialDelay,
                                                     long delay,
                                                     TimeUnit unit);
}ScheduledExecutorService 接口继承了 ExecutorService 接口,并增加了几个定时相关的接口方法。前两个方法用于单次调度执行任务,区别是有没有返回值。
重点介绍一下后面两个方法:
01、scheduleAtFixedRate
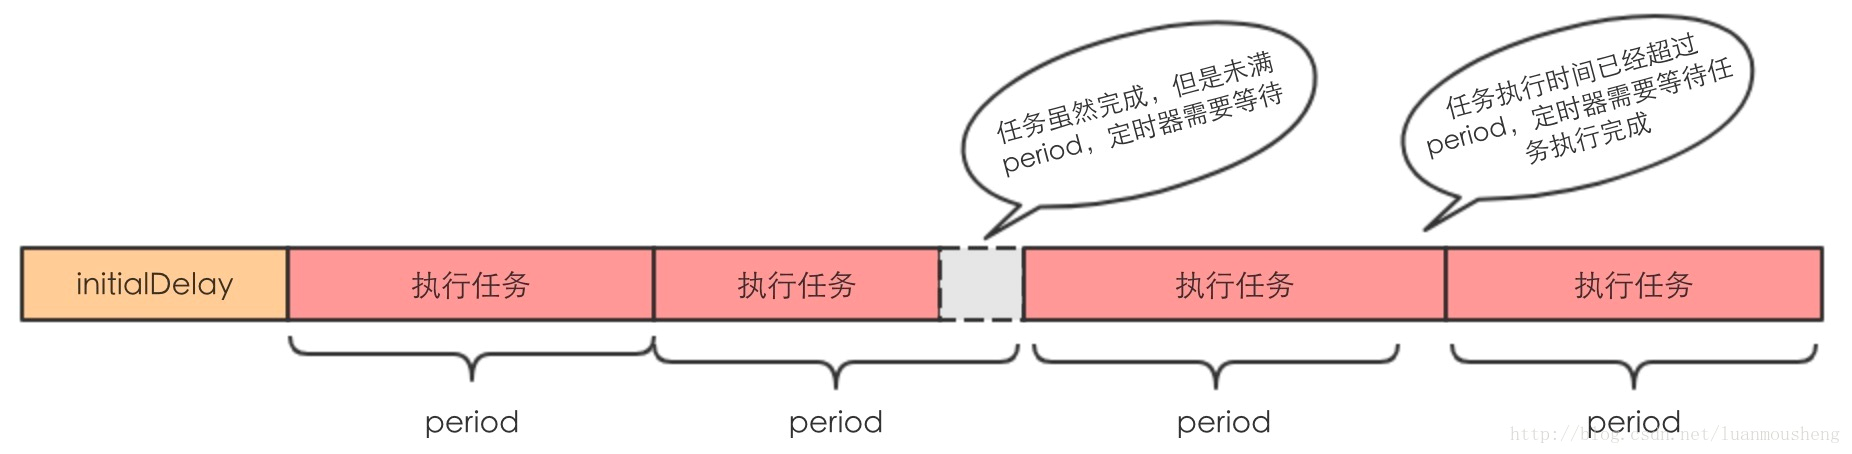
scheduleAtFixedRate 方法在initialDelay时长后第一次执行任务,以后每隔period时长再次执行任务。注意,period 是从任务开始执行算起的。开始执行任务后,定时器每隔 period 时长检查该任务是否完成,如果完成则再次启动任务,否则等该任务结束后才启动任务。看下图:
02、scheduleWithFixDelay
该方法在initialDelay时长后第一次执行任务,以后每当任务执行完成后,等待delay时长,再次执行任务。看下图。
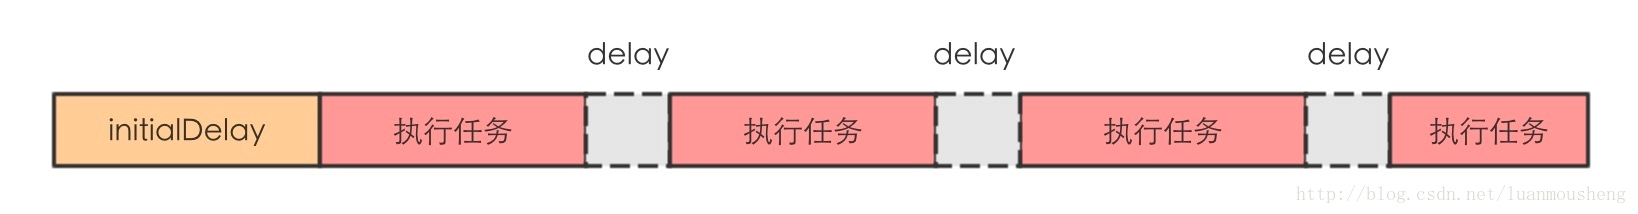
相信大家能体会出来其中的差异。
主要方法
schedule
java
// delay时长后执行任务command,该任务只执行一次
public ScheduledFuture<?> schedule(Runnable command, long delay, TimeUnit unit) {
    if (command == null || unit == null)
        throw new NullPointerException();
    // 这里的decorateTask方法仅仅返回第二个参数
    RunnableScheduledFuture<?> t = decorateTask(command,
                                   		new ScheduledFutureTask<Void>(command, null, triggerTime(delay,unit)));
    // 延时或者周期执行任务的主要方法,稍后统一说明
    delayedExecute(t);
    return t;
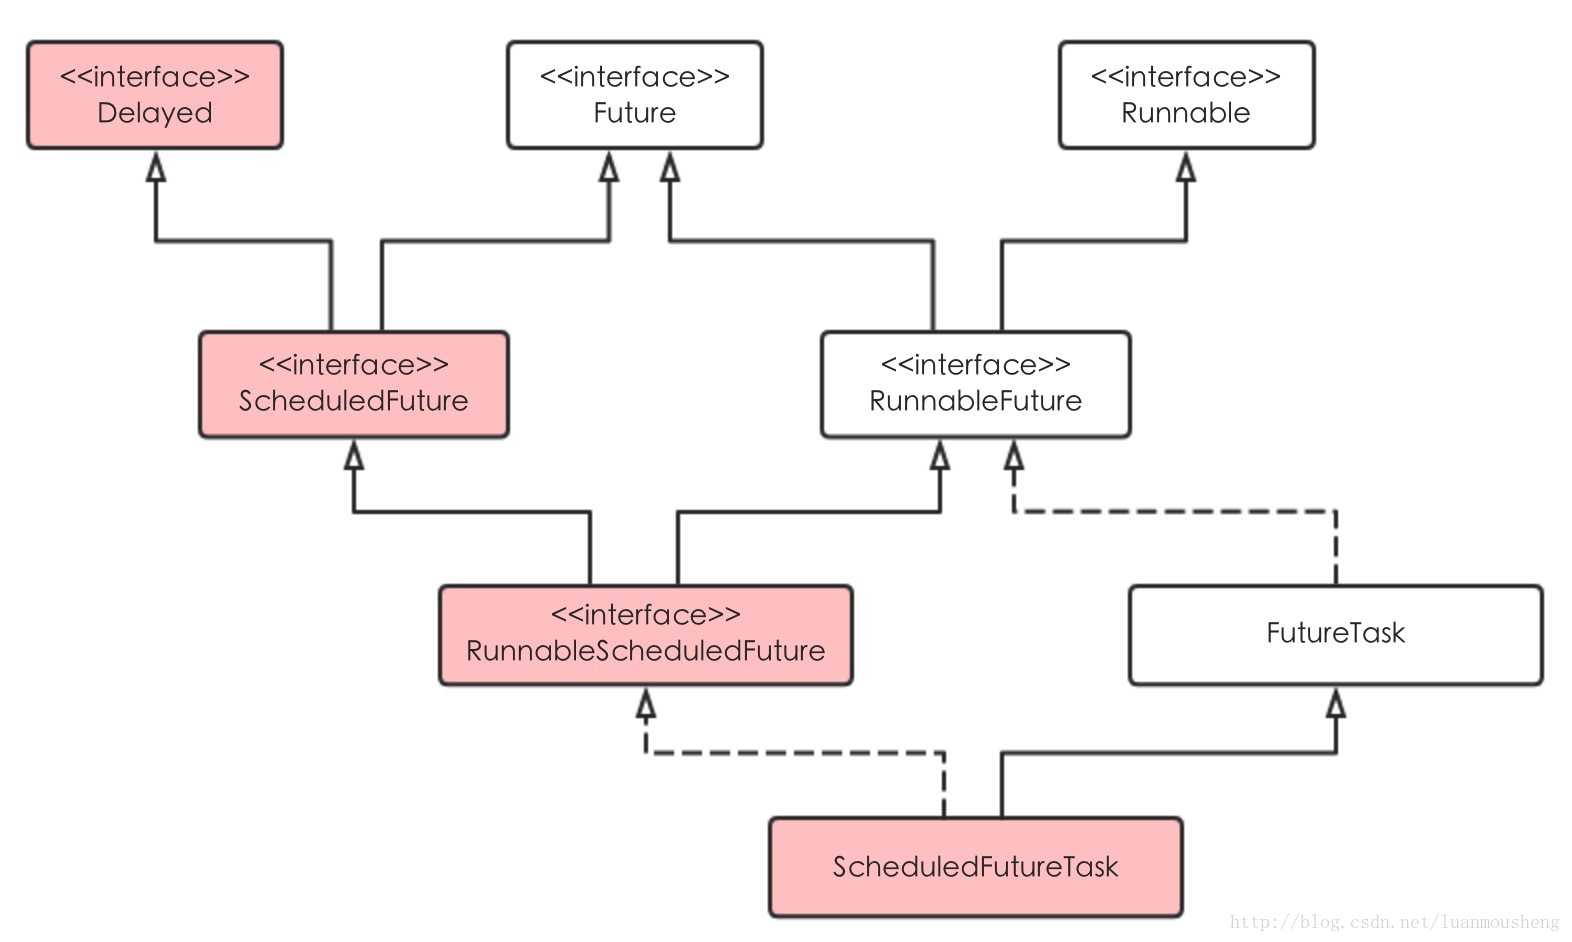
}我们先看看里面涉及到的几个类和接口的关系图谱:
Delayed 接口
java
// 继承Comparable接口,表示该类对象支持排序
public interface Delayed extends Comparable<Delayed> {
    // 返回该对象剩余时延
    long getDelay(TimeUnit unit);
}Delayed接口很简单,继承了Comparable接口,表示对象是可以比较排序的。
ScheduledFuture 接口
java
// 仅仅继承了Delayed和Future接口,自己没有任何代码
public interface ScheduledFuture<V> extends Delayed, Future<V> {
}RunnableScheduledFuture 接口
java
public interface RunnableScheduledFuture<V> extends RunnableFuture<V>, ScheduledFuture<V> {
    // 是否是周期任务,周期任务可被调度运行多次,非周期任务只被运行一次
    boolean isPeriodic();
}ScheduledFutureTask 类
回到schecule方法中,它创建了一个ScheduledFutureTask对象,由上面的关系图可知,ScheduledFutureTask直接或者间接实现了很多接口,一起看看ScheduledFutureTask里面的实现方法吧。
构造方法
java
ScheduledFutureTask(Runnable r, V result, long ns, long period) {
    // 调用父类FutureTask的构造方法
    super(r, result);
    // time表示任务下次执行的时间
    this.time = ns;
    // 周期任务,正数表示按照固定速率,负数表示按照固定时延,0表示不是周期任务
    this.period = period;
    // 任务的编号
    this.sequenceNumber = sequencer.getAndIncrement();
}Delayed 接口的实现
java
// 实现Delayed接口的getDelay方法,返回任务开始执行的剩余时间
public long getDelay(TimeUnit unit) {
    return unit.convert(time - now(), TimeUnit.NANOSECONDS);
}Comparable 接口的实现
java
// Comparable接口的compareTo方法,比较两个任务的”大小”。
public int compareTo(Delayed other) {
    if (other == this)
      return 0;
    if (other instanceof ScheduledFutureTask) {
      ScheduledFutureTask<?> x = (ScheduledFutureTask<?>)other;
      long diff = time - x.time;
      // 小于0,说明当前任务的执行时间点早于other,要排在延时队列other的前面
      if (diff < 0)
        return -1;
      // 大于0,说明当前任务的执行时间点晚于other,要排在延时队列other的后面
      else if (diff > 0)
        return 1;
      // 如果两个任务的执行时间点一样,比较两个任务的编号,编号小的排在队列前面,编号大的排在队列后面
      else if (sequenceNumber < x.sequenceNumber)
        return -1;
      else
        return 1;
    }
    // 如果任务类型不是ScheduledFutureTask,通过getDelay方法比较
    long d = (getDelay(TimeUnit.NANOSECONDS) -
              other.getDelay(TimeUnit.NANOSECONDS));
    return (d == 0) ? 0 : ((d < 0) ? -1 : 1);
}setNextRunTime
java
// 任务执行完后,设置下次执行的时间
private void setNextRunTime() {
    long p = period;
    // p > 0,说明是固定速率运行的任务
    // 在原来任务开始执行时间的基础上加上p即可
    if (p > 0)
      time += p;
    // p < 0,说明是固定时延运行的任务,
    // 下次执行时间在当前时间(任务执行完成的时间)的基础上加上-p的时间
    else
      time = triggerTime(-p);
}Runnable 接口实现
java
public void run() {
    boolean periodic = isPeriodic();
    // 如果当前状态下不能执行任务,则取消任务
    if (!canRunInCurrentRunState(periodic))
      cancel(false);
    // 不是周期性任务,执行一次任务即可,调用父类的run方法
    else if (!periodic)
      ScheduledFutureTask.super.run();
    // 是周期性任务,调用FutureTask的runAndReset方法,方法执行完成后
    // 重新设置任务下一次执行的时间,并将该任务重新入队,等待再次被调度
    else if (ScheduledFutureTask.super.runAndReset()) {
      setNextRunTime();
      reExecutePeriodic(outerTask);
    }
}总结一下 run 方法的执行过程:
- 如果当前线程池运行状态不运行执行任务,那么就取消该任务,然后直接返回,否则执行步骤 2;
- 如果不是周期性任务,调用 FutureTask 中的 run 方法执行,会设置执行结果,然后直接返回,否则执行步骤 3;
- 如果是周期性任务,调用 FutureTask 中的 runAndReset 方法执行,不会设置执行结果,然后直接返回,否则执行步骤 4 和步骤 5;
- 计算下次执行该任务的具体时间;
- 重复执行任务。
runAndReset方法是为任务多次执行而设计的。runAndReset方法执行完任务后不会设置任务的执行结果,也不会去更新任务的状态,以及维持任务的状态为初始状态(NEW状态),这也是该方法和 FutureTask run方法的区别。
scheduleAtFixedRate
我们看一下代码:
java
// 注意,固定速率和固定时延,传入的参数都是Runnable,也就是说这种定时任务是没有返回值的
public ScheduledFuture<?> scheduleAtFixedRate(Runnable command,
                                                  long initialDelay,
                                                  long period,
                                                  TimeUnit unit) {
    if (command == null || unit == null)
      throw new NullPointerException();
    if (period <= 0)
      throw new IllegalArgumentException();
    // 创建一个有初始延时和固定周期的任务
    ScheduledFutureTask<Void> sft =
      new ScheduledFutureTask<Void>(command,
                                    null,
                                    triggerTime(initialDelay, unit),
                                    unit.toNanos(period));
    RunnableScheduledFuture<Void> t = decorateTask(command, sft);
    // outerTask表示将会重新入队的任务
    sft.outerTask = t;
    // 稍后说明
    delayedExecute(t);
    return t;
}scheduleAtFixedRate这个方法和schedule类似,不同点是scheduleAtFixedRate方法内部创建的是ScheduledFutureTask,带有初始延时和固定周期的任务。
scheduleWithFixedDelay
scheduleWithFixedDelay也是通过ScheduledFutureTask体现的,唯一不同的地方在于创建的ScheduledFutureTask不同。
java
public ScheduledFuture<?> scheduleWithFixedDelay(Runnable command,
                                                     long initialDelay,
                                                     long delay,
                                                     TimeUnit unit) {
    if (command == null || unit == null)
      throw new NullPointerException();
    if (delay <= 0)
      throw new IllegalArgumentException();
    // 创建一个有初始延时和固定时延的任务
    ScheduledFutureTask<Void> sft =
      new ScheduledFutureTask<Void>(command,
                                    null,
                                    triggerTime(initialDelay, unit),
                                    unit.toNanos(-delay));
    RunnableScheduledFuture<Void> t = decorateTask(command, sft);
    // outerTask表示将会重新入队的任务
    sft.outerTask = t;
    // 稍后说明
    delayedExecute(t);
    return t;
}delayedExecute
前面讲到的schedule、scheduleAtFixedRate和scheduleWithFixedDelay最后都调用了delayedExecute方法,该方法是定时任务执行的主要方法。 一起来看看源码:
java
private void delayedExecute(RunnableScheduledFuture<?> task) {
    // 线程池已经关闭,调用拒绝执行处理器处理
    if (isShutdown())
      reject(task);
    else {
      // 将任务加入到等待队列
      super.getQueue().add(task);
      // 线程池已经关闭,且当前状态不能运行该任务,将该任务从等待队列移除并取消该任务
      if (isShutdown() &&
          !canRunInCurrentRunState(task.isPeriodic()) &&
          remove(task))
        task.cancel(false);
      else
        // 增加一个worker,就算corePoolSize=0也要增加一个worker
        ensurePrestart();
    }
}delayedExecute方法的逻辑也很简单,主要就是将任务添加到等待队列,然后调用ensurePrestart方法。
java
void ensurePrestart() {
    int wc = workerCountOf(ctl.get());
    if (wc < corePoolSize)
        addWorker(null, true);
    else if (wc == 0)
        addWorker(null, false);
}ensurePrestart方法主要是调用了addWorker 方法,线程池中的工作线程就是通过该方法来启动并执行任务的。相信大家都还有印象。
对于ScheduledThreadPoolExecutor,worker添加到线程池后会在等待队列中等待获取任务,这点是和ThreadPoolExecutor是一致的。但是 worker 是怎么从等待队列取定时任务的呢?
DelayedWorkQueue
ScheduledThreadPoolExecutor使用了DelayedWorkQueue 来保存等待的任务。
该等待队列的队首应该保存的是最近将要执行的任务,所以worker只关心队首任务,如果队首任务的开始执行时间还未到,worker 也应该继续等待。
DelayedWorkQueue 是一个无界优先队列,使用数组存储,底层使用堆结构来实现优先队列的功能。
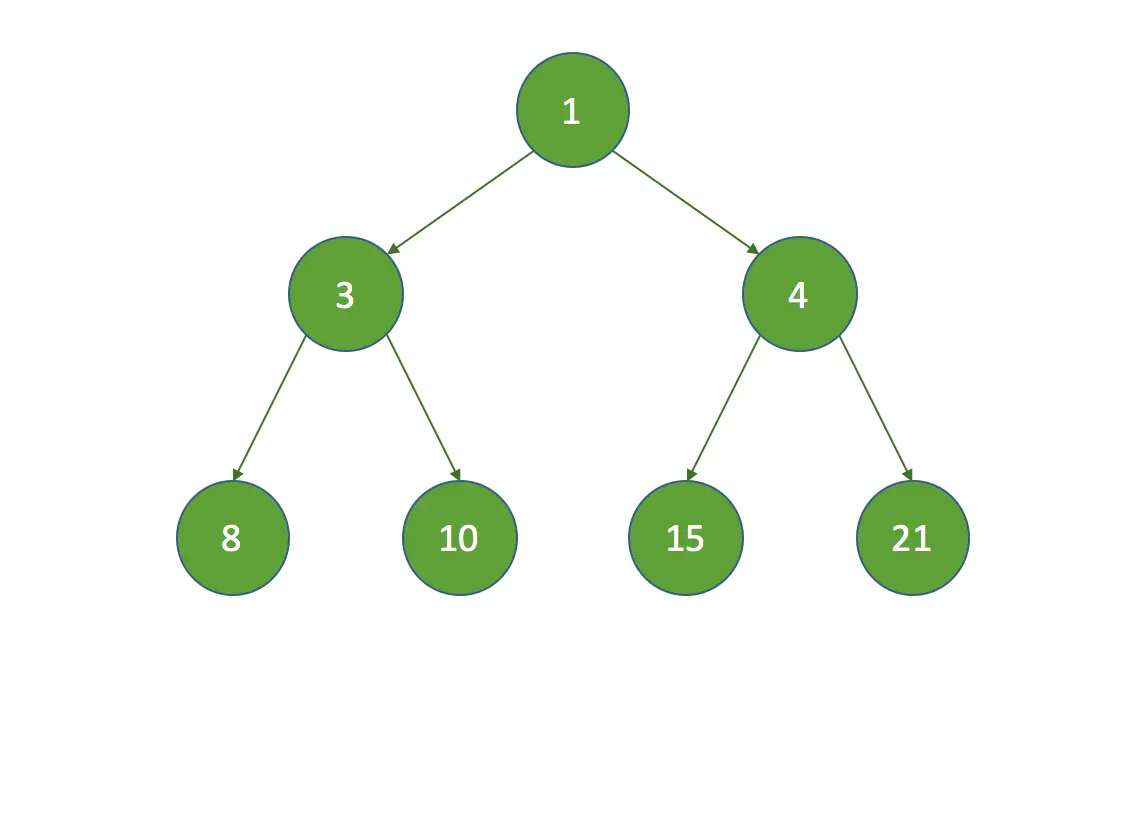
可以转换成如下的数组:
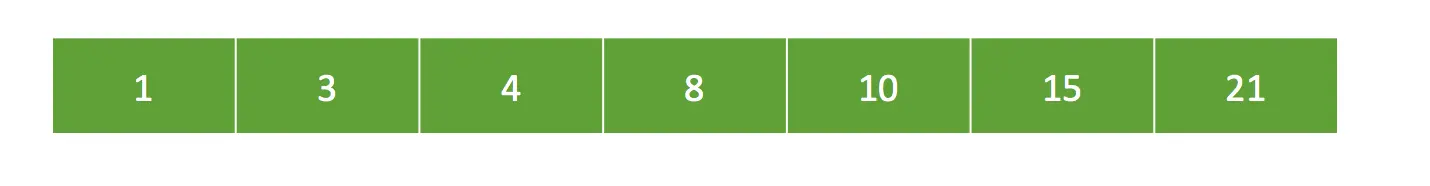
在这种结构中,可以发现有如下特性。假设,索引值从 0 开始,子节点的索引值为 k,父节点的索引值为 p,则:
- 一个节点的左子节点的索引为:k = p * 2 + 1;
- 一个节点的右子节点的索引为:k = (p + 1) * 2;
- 一个节点的父节点的索引为:p = (k - 1) / 2。
我们来看看 DelayedWorkQueue 的声明和成员变量:
java
static class DelayedWorkQueue extends AbstractQueue<Runnable>
implements BlockingQueue<Runnable> {
	// 队列初始容量
	private static final int INITIAL_CAPACITY = 16;
	// 数组用来存储定时任务,通过数组实现堆排序
	private RunnableScheduledFuture[] queue = new RunnableScheduledFuture[INITIAL_CAPACITY];
	// 当前在队首等待的线程
	private Thread leader = null;
	// 锁和监视器,用于leader线程
	private final ReentrantLock lock = new ReentrantLock();
	private final Condition available = lock.newCondition();
	// 其他代码,略
}当一个线程成为 leader,它只需等待队首任务的 delay 时间即可,其他线程会无条件等待。leader 取到任务返回前要通知其他线程,直到有线程成为新的 leader。每当队首的定时任务被其他更早需要执行的任务替换,leader 就设置为 null,其他等待的线程(被当前 leader 通知)和当前的 leader 重新竞争成为 leader。
所有线程都会有三种身份中的一种:leader、follower,以及一个干活中的状态:proccesser。它的基本原则是,永远最多只有一个 leader。所有 follower 都在等待成为 leader。线程池启动时会自动产生一个 Leader 负责等待网络 IO 事件,当有一个事件产生时,Leader 线程首先通知一个 Follower 线程将其提拔为新的 Leader,然后自己就去干活了,去处理这个网络事件,处理完毕后加入 Follower 线程等待队列,等待下次成为 Leader。这种方法可以增强 CPU 高速缓存相似性,及消除动态内存分配和线程间的数据交换。
同时,定义了 ReentrantLock 锁 lock 和 Condition available 用于控制和通知下一个线程竞争成为 leader。
当一个新的任务成为队首,或者需要有新的线程成为 leader 时,available 监视器上的线程将会被通知,然后竞争成为 leader 线程。有些类似于生产者-消费者模式。
DelayedWorkQueue 是一个优先级队列,它可以保证每次出队的任务都是当前队列中执行时间最靠前的,由于它是基于堆结构的队列,堆结构在执行插入和删除操作时的最坏时间复杂度是 O(logN)。
接下来看看DelayedWorkQueue中几个比较重要的方法。
take
java
public RunnableScheduledFuture take() throws InterruptedException {
    final ReentrantLock lock = this.lock;
    lock.lockInterruptibly();
    try {
      for (;;) {
        // 取堆顶的任务,堆顶是最近要执行的任务
        RunnableScheduledFuture first = queue[0];
        // 堆顶为空,线程要在条件available上等待
        if (first == null)
          available.await();
        else {
          // 堆顶任务还要多长时间才能执行
          long delay = first.getDelay(TimeUnit.NANOSECONDS);
          // 堆顶任务已经可以执行了,finishPoll会重新调整堆,使其满足最小堆特性,该方法设置任务在
          // 堆中的index为-1并返回该任务
          if (delay <= 0)
            return finishPoll(first);
          // 如果leader不为空,说明已经有线程成为leader并等待堆顶任务
          // 到达执行时间,此时,其他线程都需要在available条件上等待
          else if (leader != null)
            available.await();
          else {
            // leader为空,当前线程成为新的leader
            Thread thisThread = Thread.currentThread();
            leader = thisThread;
            try {
              // 当前线程已经成为leader了,只需要等待堆顶任务到达执行时间即可
              available.awaitNanos(delay);
            } finally {
              // 返回堆顶元素之前将leader设置为空
              if (leader == thisThread)
                leader = null;
            }
          }
        }
      }
    } finally {
      // 通知其他在available条件等待的线程,这些线程可以去竞争成为新的leader
      if (leader == null && queue[0] != null)
        available.signal();
      lock.unlock();
    }
}take方法是什么时候调用的呢?
在讲解线程池的时候,我们介绍了getTask方法,工作线程会循环从workQueue中取任务。但计划任务却不同,因为一旦getTask方法取出了任务就开始执行了,而这时可能还没有到执行时间,所以在take方法中,要保证只有到指定的执行时间,任务才可以被取走。
总结一下流程:
- 如果堆顶元素为空,在 available 上等待。
- 如果堆顶任务的执行时间已到,将堆顶元素替换为堆的最后一个元素并调整堆使其满足最小堆特性,同时设置任务在堆中索引为-1,返回该任务。
- 如果 leader 不为空,说明已经有线程成为 leader 了,其他线程都要在 available 监视器上等待。
- 如果 leader 为空,当前线程成为新的 leader,并等待直到堆顶任务执行时间到达。
- take 方法返回之前,将 leader 设置为空,并通知其他线程。
再来说一下 leader 的作用,这里的 leader 是为了减少不必要的定时等待,当一个线程成为 leader 时,它只等待下一个节点的时间间隔,但其它线程无限期等待。 leader 线程必须在take()或poll()返回之前 signal 其它线程,除非其他线程成为了 leader。
举例来说,如果没有 leader,那么在执行 take 时,都要执行available.awaitNanos(delay),假设当前线程执行了该段代码,这时还没有 signal,第二个线程也执行了该段代码,则第二个线程也要被阻塞。
但只有一个线程返回队首任务,其他的线程在awaitNanos(delay)之后,继续执行 for 循环,因为队首任务已经被返回了,所以这个时候的 for 循环拿到的队首任务是新的,又需要重新判断时间,又要继续阻塞。
所以,为了不让多个线程频繁的做无用的定时等待,这里增加了 leader,如果 leader 不为空,则说明队列中第一个节点已经在等待出队,这时其它的线程会一直阻塞,减少了无用的阻塞(注意,在finally中调用了signal()来唤醒一个线程,而不是signalAll())。
offer
该方法往队列插入一个值,返回是否成功插入。
java
public boolean offer(Runnable x) {
    if (x == null)
      throw new NullPointerException();
    RunnableScheduledFuture e = (RunnableScheduledFuture)x;
    final ReentrantLock lock = this.lock;
    lock.lock();
    try {
      int i = size;
      // 队列元素已经大于等于数组的长度,需要扩容,新堆的容量是原来堆容量的1.5倍
      if (i >= queue.length)
        grow();
      // 堆中元素增加1
      size = i + 1;
      // 调整堆
      if (i == 0) {
        queue[0] = e;
        setIndex(e, 0);
      } else {
          // 调整堆,使的满足最小堆,比较大小的方式就是上文提到的compareTo方法
        siftUp(i, e);
      }
      if (queue[0] == e) {
        leader = null;
        // 通知其他在available条件上等待的线程,这些线程可以竞争成为新的leader
        available.signal();
      }
    } finally {
      lock.unlock();
    }
    return true;
}offer 方法实现了向延迟队列插入一个任务的操作,并保证整个队列仍然满足最小堆的性质。
最小堆(Min Heap)是一个完全二叉树,其中每一个父节点的值都小于或等于其子节点的值。换句话说,在最小堆中,根节点(即树的顶部)是所有节点中的最小值。
前面我们也提到过最小堆。我们来看一下用于调整堆的 siftUp 方法。
java
private void siftUp(int k, RunnableScheduledFuture<?> key) {
    while (k > 0) {
        // 找到父节点的索引
        int parent = (k - 1) >>> 1;
        // 获取父节点
        RunnableScheduledFuture<?> e = queue[parent];
        // 如果key节点的执行时间大于父节点的执行时间,不需要再排序了
        if (key.compareTo(e) >= 0)
            break;
        // 如果key.compareTo(e) < 0,说明key节点的执行时间小于父节点的执行时间,需要把父节点移到后面
        queue[k] = e;
        // 设置索引为k
        setIndex(e, k);
        k = parent;
    }
    // key设置为排序后的位置中
    queue[k] = key;
    setIndex(key, k);
}代码很好理解,就是循环的根据key节点与它的父节点来判断,如果key节点的执行时间小于父节点,则将两个节点交换,使执行时间靠前的节点排列在队列的前面。
假设新入队的节点的延迟时间(调用getDelay()方法获得)是5,执行过程如下:
1、先将新的节点添加到数组的尾部,这时新节点的索引k为7:
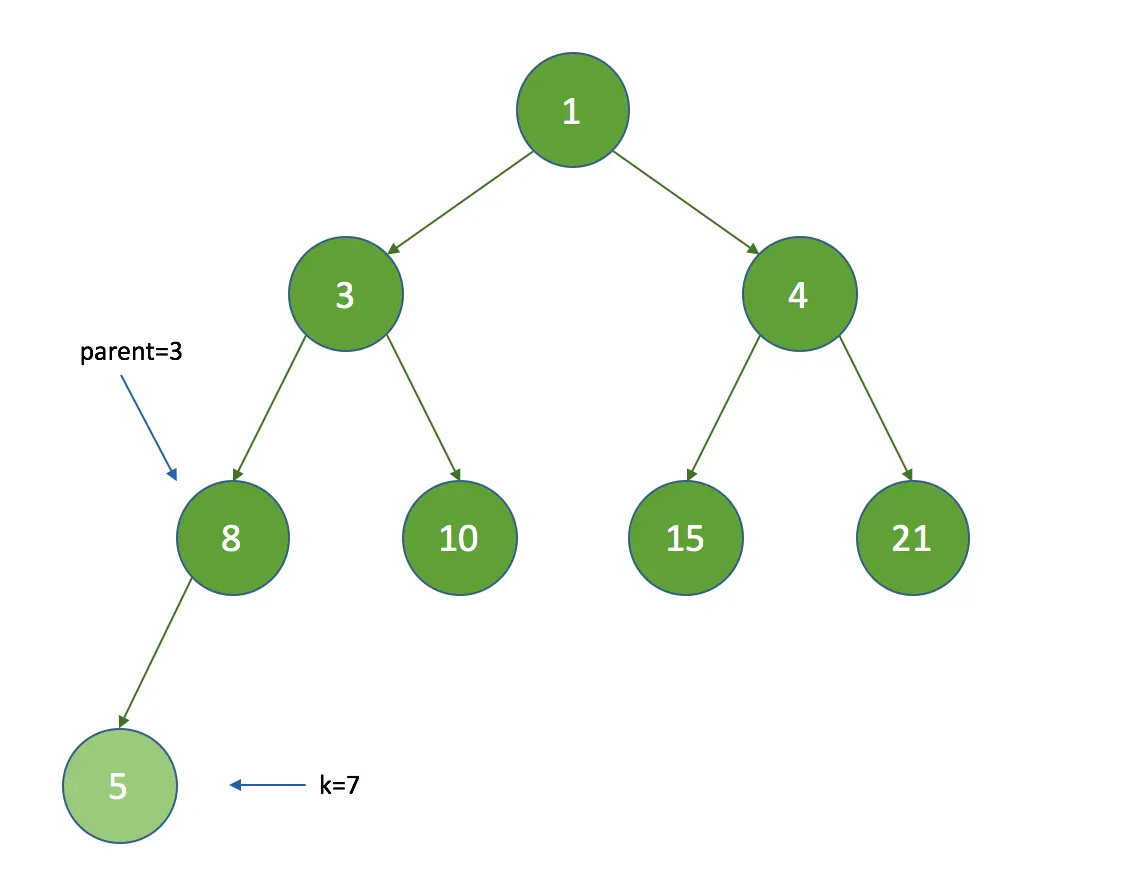
2、计算新父节点的索引:parent = (k - 1) >>> 1,parent = 3,那么queue[3]的时间间隔值为8,因为 5 < 8 ,将执行queue[7] = queue[3]:
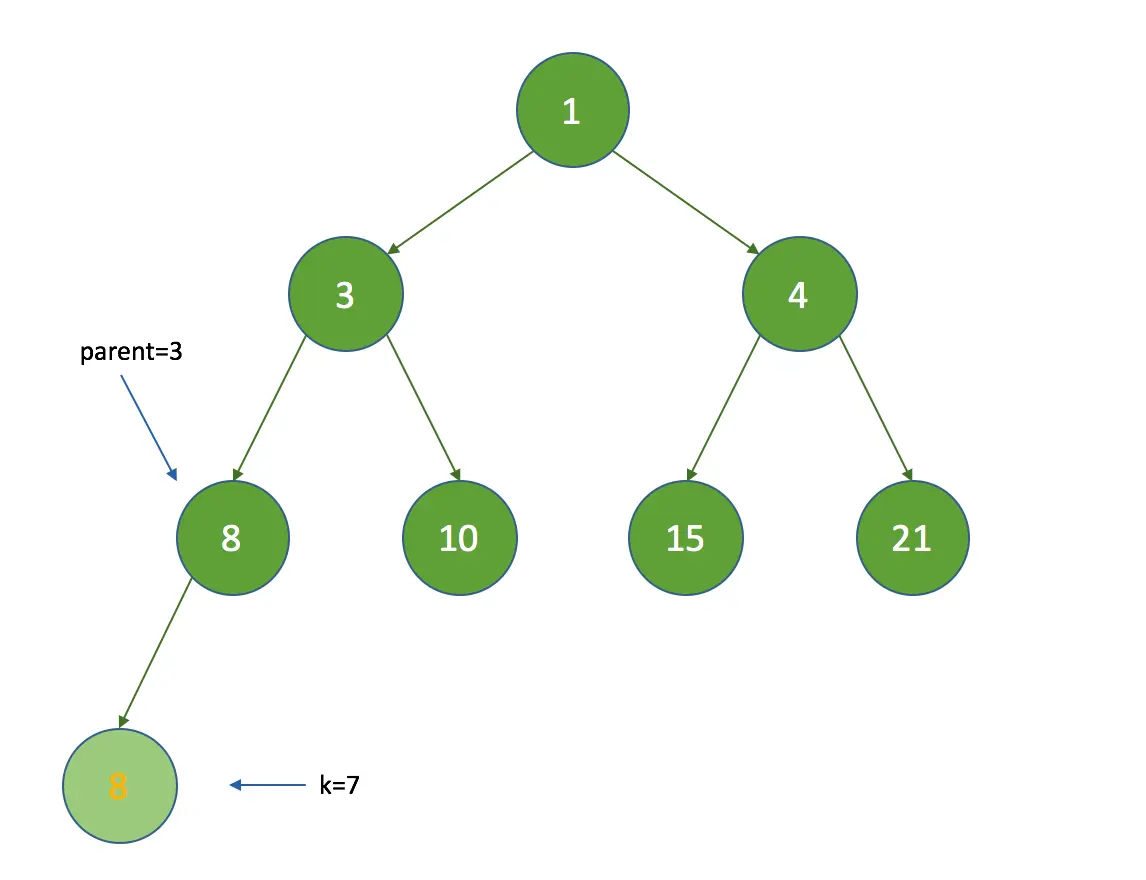
3、这时将k设置为3,继续循环,再次计算parent为1,queue[1]的时间间隔为3,因为 5 > 3 ,这时退出循环,最终k为3:
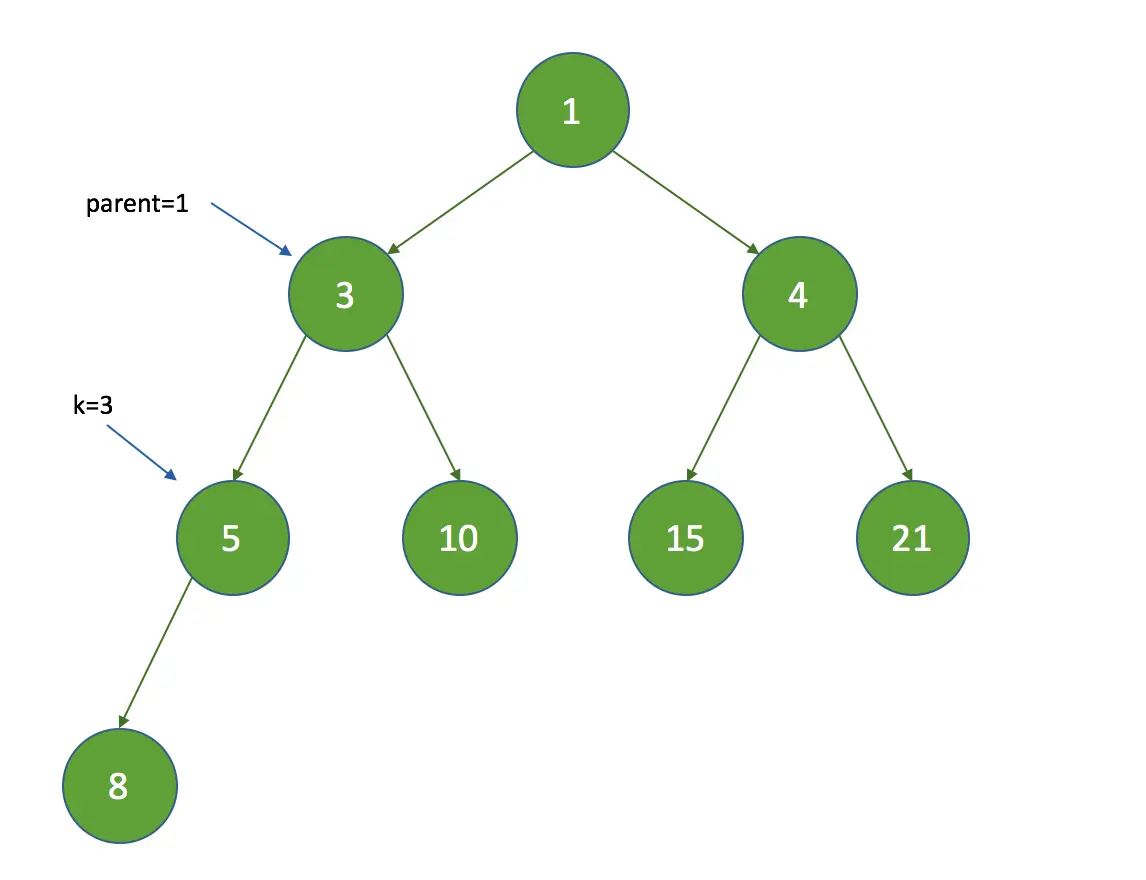
可见,每次新增节点时,只是根据父节点来判断,而不会影响兄弟节点。
小结
ScheduledThreadPoolExecutor是一个定时任务的线程池,它的主要作用是周期性的执行任务。它的实现原理是通过DelayedWorkQueue来保存等待的任务,DelayedWorkQueue是一个无界优先队列,使用数组存储,底层使用堆结构来实现优先队列的功能。
编辑:沉默王二,原文内容来源于朋友小七萤火虫开源的这个仓库:深入浅出 Java 多线程,强烈推荐。其他参考链接如下:
推荐阅读:读者三友的 11 种延迟任务的实现方式
GitHub 上标星 17000+ 的开源知识库《二哥的 Java 进阶之路》第二份 PDF 《并发编程小册》终于来了!包括线程的基本概念和使用方法、Java的内存模型、sychronized、volatile、CAS、AQS、ReentrantLock、线程池、并发容器、ThreadLocal、生产者消费者模型等面试和开发必须掌握的内容,共计 15 万余字,200+张手绘图,可以说是通俗易懂、风趣幽默……详情戳:太赞了,二哥的并发编程进阶之路.pdf
加入二哥的编程星球,在星球的第二个置顶帖「知识图谱」里就可以获取 PDF 版本。