主题
整理自沉默王二(二哥)javabetter.cn《AI Agent 面试 296 题合集》:原文。全文搬运仅供个人学习,请勿外传。
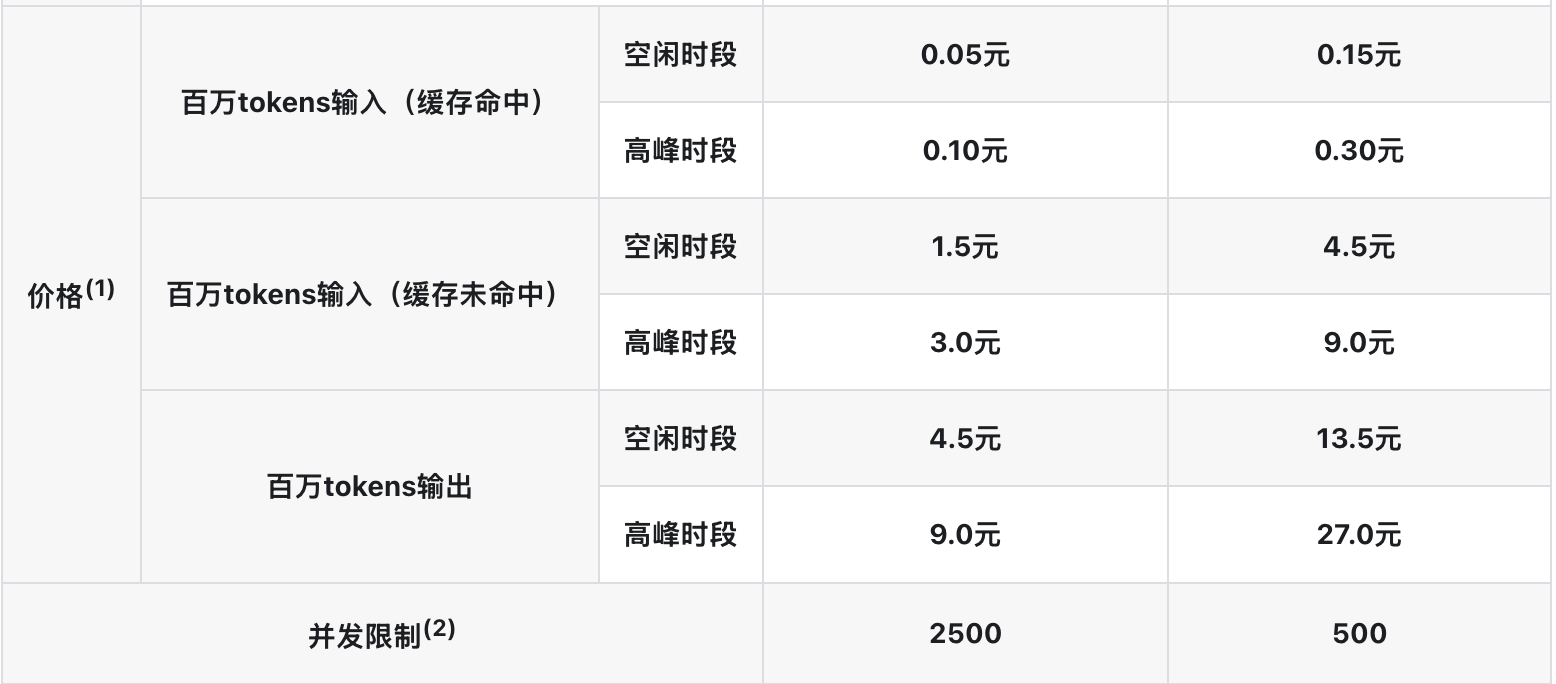
面试官问你:“DeepSeek V4 正式涨价后,Flash 缓存命中的价格是每百万 token 输入 0.1 元(高峰时段),未命中 3 元,差了 30 倍。缓存命中之所以便宜,除了因为跳过 Prefill 计算之外,你还知道其他原因吗?”
如果你回答“用了什么压缩技术吧”,恭喜你,出门右拐回家等通知吧。
为什么?
因为面试官真正想让你回答的是:缓存命中之所以便宜,不只是因为跳过了 Prefill 计算,更因为 V4 的注意力机制把 KV Cache 的显存占用压到了 V3 的 7%,存储成本断崖式下降。
我翻了 DeepSeek V4 的技术报告、vLLM 的技术博客,可以自信地、大方地、光明磊落地帮你搞清楚这两件事:
- V4 的 CSA 和 HCA 到底是怎么压缩 KV Cache 的?
- 这对我们开发者意味着什么?
哈喽大家好,我是二哥呀。今天用 3 分钟,给你讲清楚 DeepSeek V4 是怎么把 KV Cache 压缩到只有 V3 的 7% 的。
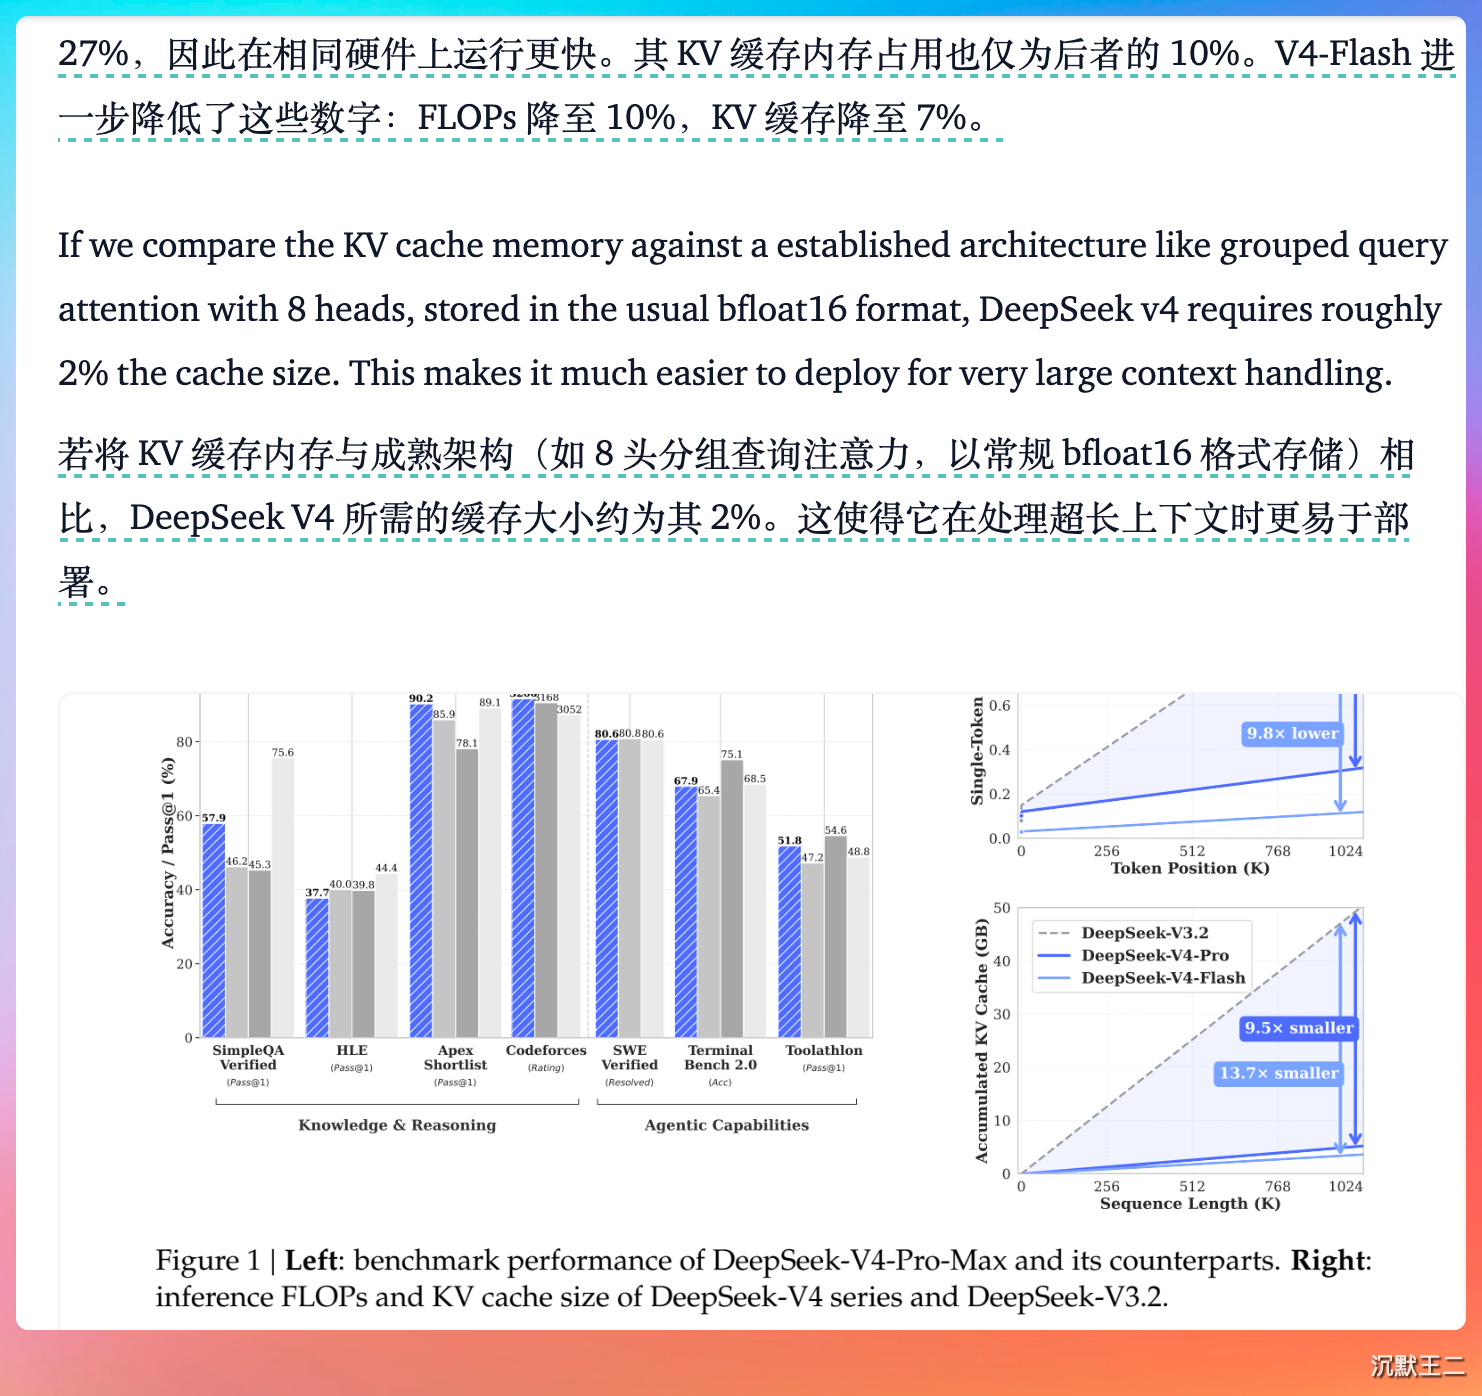
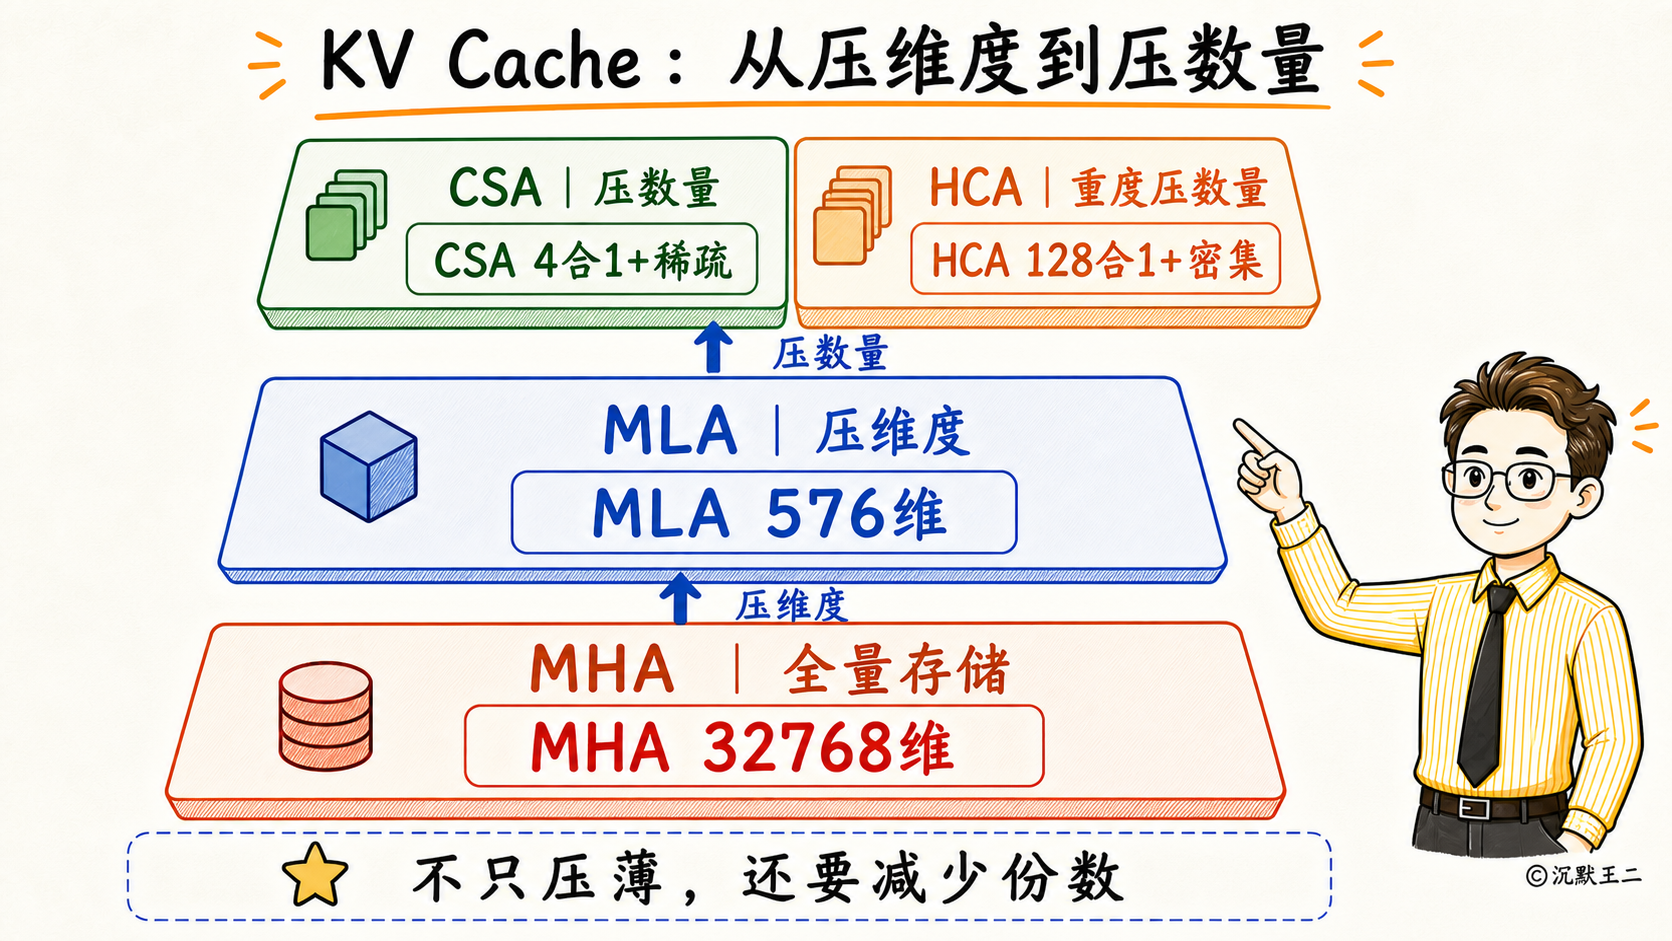
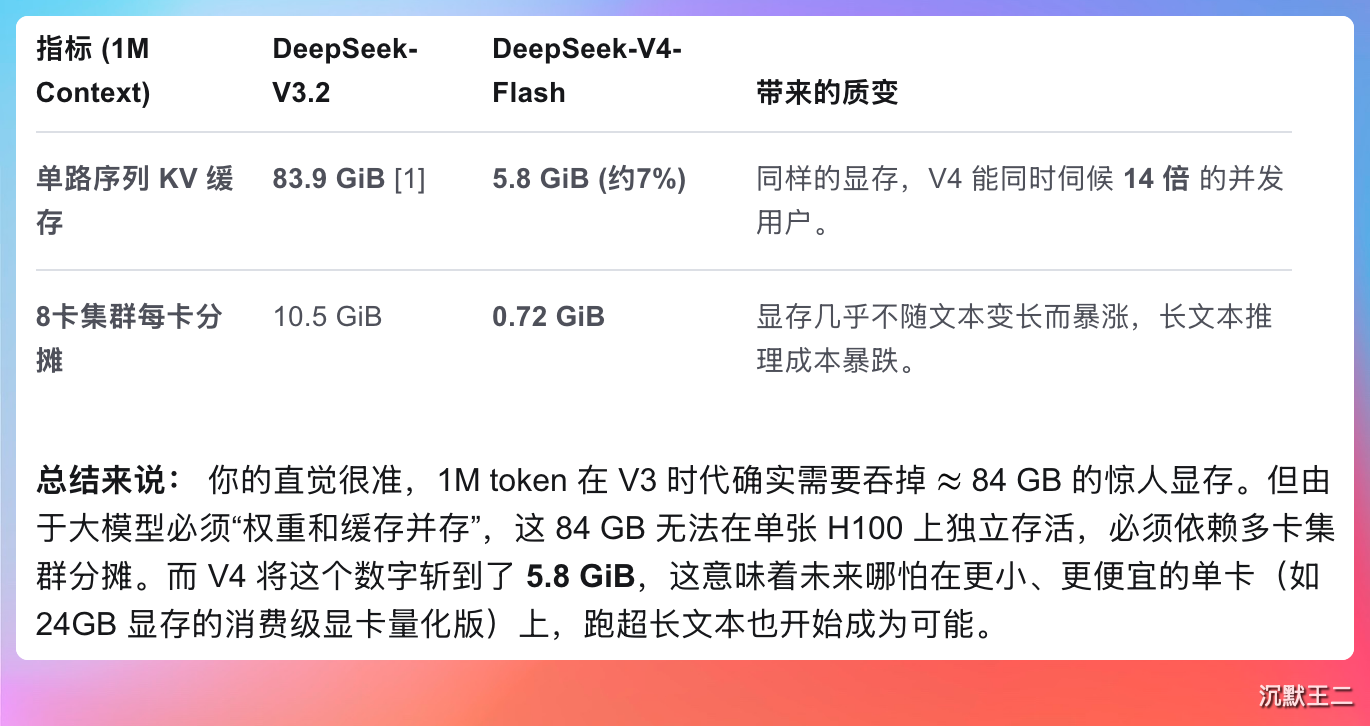
上期我们讲过,MLA 把每个 token 的 KV 数据压薄了,但每个 token 还是要存一份。100 万个 token,就是 100 万份,V3 大约要吃掉 84 GB 显存——一张顶配 H100 啊。
V4 换了思路:不只在单份数据上做文章,更直接减少要存的份数。主要靠两个新机制:CSA 和 HCA。
CSA,Compressed Sparse Attention,也就是压缩稀疏注意力。它负责做两件事。
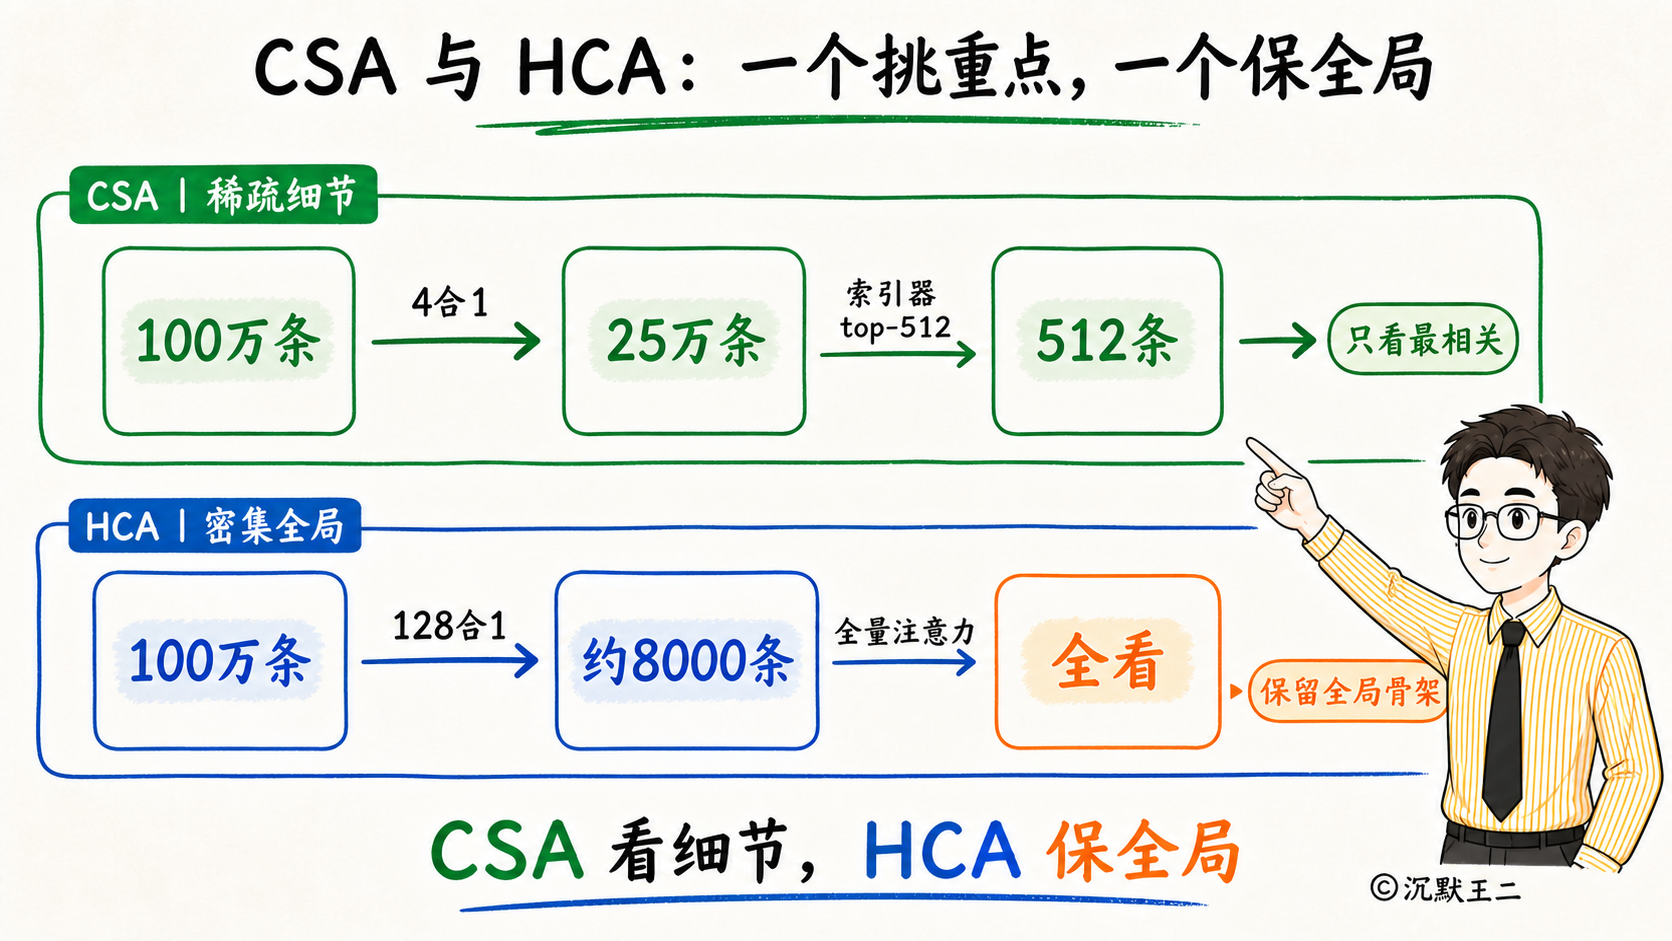
第一件,压缩。每 4 个相邻的 token 合并成 1 份。于是 100 万份就减少到了 25 万份。
第二件,稀疏。通过一个索引器——你可以把它理解成书的目录——算注意力的时候,不是 25 万条全看,而是先给每条打分,只挑最相关的 512 条来计算。
HCA,Heavily Compressed Attention,重度压缩注意力。听名字就知道,比 CSA 压得更狠——每 128 个 token 合并成 1 份。100 万份减少到约 8000 份。
聪明的你可能会问:CSA 只挑 512 条,不怕漏掉关键信息吗?HCA 把 128 个 token 合并成一份,细节不都没了吗?
恰恰相反。
HCA 的每一份都装着一小段原文的大意,8000 份拼起来,整篇文档的骨架就有了,信息丢不了;CSA 则负责在细节里挑重点。一个保全局、一个看细节,互相兜底。
打个比方。CSA 是你写的课堂笔记——每 4 分钟记一段,复习的时候只翻跟考题相关的几页。HCA 是课程大纲——一节课浓缩成一句话,随时能查看整个学期讲了什么。
两套机制一叠加,V4 Flash 的 KV Cache 就只有 V3 的 7%。
那聪明的你肯定又要问了:7% 对我们开发者有什么用?
同一张 GPU 卡,显存是固定的,同时跑的每个请求都要占一块显存。以前一百万个 token 的请求就能吃掉一整张卡,现在只占个零头,意味着一张卡能同时服务十几个请求。这也是 V4 敢把上下文窗口默认开到 100 万的底气。
哪怕涨了价,V4 Flash 高峰期的未命中价格,在百万 token 上下文这个量级下,依然非常有竞争力。
最后简单总结下。
上期讲了 V4 为什么要换掉 MLA,这期讲的是接棒的 CSA 和 HCA 怎么把 KV Cache 压到 7%。
这个知识点你学废了吗?想解锁更多 AI 硬核知识,点赞关注,我是二哥,咱们下期见!