主题
整理自 JavaGuide:原文。全文搬运仅供个人学习,请勿外传。
Map(重要)
⭐️ HashMap 和 Hashtable 的区别
- 线程是否安全:
HashMap是非线程安全的,Hashtable是线程安全的,因为Hashtable内部的方法基本都经过synchronized修饰。(如果你要保证线程安全的话就使用ConcurrentHashMap吧!); - 效率: 因为线程安全的问题,
HashMap要比Hashtable效率高一点。另外,Hashtable基本被淘汰,不要在代码中使用它; - 对 Null key 和 Null value 的支持:
HashMap可以存储 null 的 key 和 value,但 null 作为键只能有一个,null 作为值可以有多个;Hashtable 不允许有 null 键和 null 值,否则会抛出NullPointerException。 - 初始容量大小和每次扩充容量大小的不同: ① 创建时如果不指定容量初始值,
Hashtable默认的初始大小为 11,之后每次扩充,容量变为原来的 2n+1。HashMap默认的初始化大小为 16。之后每次扩充,容量变为原来的 2 倍。② 创建时如果给定了容量初始值,那么Hashtable会直接使用你给定的大小,而HashMap会将其扩充为 2 的幂次方大小(HashMap中的tableSizeFor()方法保证,下面给出了源代码)。也就是说HashMap总是使用 2 的幂作为哈希表的大小,后面会介绍到为什么是 2 的幂次方。 - 底层数据结构: JDK1.8 以后的
HashMap在解决哈希冲突时有了较大的变化,当链表长度大于阈值(默认为 8)时,将链表转化为红黑树(将链表转换成红黑树前会判断,如果当前数组的长度小于 64,那么会选择先进行数组扩容,而不是转换为红黑树),以减少搜索时间(后文中我会结合源码对这一过程进行分析)。Hashtable没有这样的机制。 - 哈希函数的实现:
HashMap对哈希值进行了高位和低位的混合扰动处理以减少冲突,而Hashtable直接使用键的hashCode()值。
HashMap 中带有初始容量的构造函数:
java
    public HashMap(int initialCapacity, float loadFactor) {
        if (initialCapacity < 0)
            throw new IllegalArgumentException("Illegal initial capacity: " +
                                               initialCapacity);
        if (initialCapacity > MAXIMUM_CAPACITY)
            initialCapacity = MAXIMUM_CAPACITY;
        if (loadFactor <= 0 || Float.isNaN(loadFactor))
            throw new IllegalArgumentException("Illegal load factor: " +
                                               loadFactor);
        this.loadFactor = loadFactor;
        this.threshold = tableSizeFor(initialCapacity);
    }
     public HashMap(int initialCapacity) {
        this(initialCapacity, DEFAULT_LOAD_FACTOR);
}下面这个方法保证了 HashMap 总是使用 2 的幂作为哈希表的大小。
java
/**
 * Returns a power of two size for the given target capacity.
 */
static final int tableSizeFor(int cap) {
    int n = cap - 1;
    n |= n >>> 1;
    n |= n >>> 2;
    n |= n >>> 4;
    n |= n >>> 8;
    n |= n >>> 16;
    return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1;
}HashMap 和 HashSet 区别
如果你看过 HashSet 源码的话就应该知道:HashSet 底层就是基于 HashMap 实现的。(HashSet 的源码非常非常少,因为除了 clone()、writeObject()、readObject() 是 HashSet 自己不得不实现之外,其他方法都是直接调用 HashMap 中的方法。
HashMap | HashSet |
|---|---|
实现了 Map 接口 | 实现 Set 接口 |
| 存储键值对 | 仅存储对象 |
调用 put()向 map 中添加元素 | 调用 add()方法向 Set 中添加元素 |
HashMap 使用键(Key)计算 hashcode | HashSet 使用成员对象来计算 hashcode 值,对于两个对象来说 hashcode 可能相同,所以equals()方法用来判断对象的相等性 |
⭐️ HashMap 和 TreeMap 区别
TreeMap 和 HashMap 都继承自 AbstractMap,但是需要注意的是 TreeMap 它还实现了 NavigableMap 接口和 SortedMap 接口。
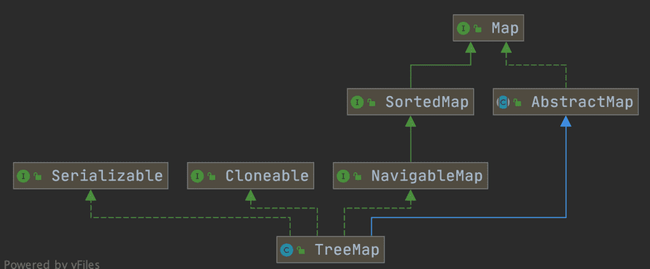
实现 NavigableMap 接口让 TreeMap 有了对集合内元素的搜索的能力。
NavigableMap 接口提供了丰富的方法来探索和操作键值对:
- 定向搜索:
ceilingEntry(),floorEntry(),higherEntry()和lowerEntry()等方法可以用于定位大于等于、小于等于、严格大于、严格小于给定键的最接近的键值对。 - 子集操作:
subMap(),headMap()和tailMap()方法可以高效地创建原集合的子集视图,而无需复制整个集合。 - 逆序视图:
descendingMap()方法返回一个逆序的NavigableMap视图,使得可以反向迭代整个TreeMap。 - 边界操作:
firstEntry(),lastEntry(),pollFirstEntry()和pollLastEntry()等方法可以方便地访问和移除元素。
这些方法都是基于红黑树数据结构的属性实现的,红黑树保持平衡状态,从而保证了搜索操作的时间复杂度为 O(log n),这让 TreeMap 成为了处理有序集合搜索问题的强大工具。
实现 SortedMap 接口让 TreeMap 有了对集合中的元素根据键排序的能力。默认是按 key 的升序排序,不过我们也可以指定排序的比较器。示例代码如下:
java
/**
 * @author shuang.kou
 * @createTime 2020年06月15日 17:02:00
 */
public class Person {
    private Integer age;

    public Person(Integer age) {
        this.age = age;
    }

    public Integer getAge() {
        return age;
    }


    public static void main(String[] args) {
        TreeMap<Person, String> treeMap = new TreeMap<>(new Comparator<Person>() {
            @Override
            public int compare(Person person1, Person person2) {
                int num = person1.getAge() - person2.getAge();
                return Integer.compare(num, 0);
            }
        });
        treeMap.put(new Person(3), "person1");
        treeMap.put(new Person(18), "person2");
        treeMap.put(new Person(35), "person3");
        treeMap.put(new Person(16), "person4");
        treeMap.entrySet().stream().forEach(personStringEntry -> {
            System.out.println(personStringEntry.getValue());
        });
    }
}输出:
plain
person1
person4
person2
person3可以看出,TreeMap 中的元素已经是按照 Person 的 age 字段的升序来排列了。
上面,我们是通过传入匿名内部类的方式实现的,你可以将代码替换成 Lambda 表达式实现的方式:
java
TreeMap<Person, String> treeMap = new TreeMap<>((person1, person2) -> {
  int num = person1.getAge() - person2.getAge();
  return Integer.compare(num, 0);
});综上,相比于 HashMap 来说, TreeMap 主要多了对集合中的元素根据键排序的能力以及对集合内元素的搜索的能力。
HashSet 如何检查重复?
以下内容摘自我的 Java 启蒙书《Head first java》第二版:
当你把对象加入
HashSet时,HashSet会先计算对象的hashcode值来判断对象加入的位置,同时也会与其他加入的对象的hashcode值作比较,如果没有相符的hashcode,HashSet会假设对象没有重复出现。但是如果发现有相同hashcode值的对象,这时会调用equals()方法来检查hashcode相等的对象是否真的相同。如果两者相同,HashSet就不会让加入操作成功。
在 JDK1.8 中,HashSet 的 add() 方法只是简单的调用了 HashMap 的 put() 方法,并且判断了一下返回值以确保是否有重复元素。直接看一下 HashSet 中的源码:
java
// Returns: true if this set did not already contain the specified element
// 返回值:当 set 中没有包含 add 的元素时返回真
public boolean add(E e) {
        return map.put(e, PRESENT)==null;
}而在 HashMap 的 putVal() 方法中也能看到如下说明:
java
// Returns : previous value, or null if none
// 返回值:如果插入位置没有元素返回null,否则返回上一个元素
final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
                   boolean evict) {
...
}也就是说,在 JDK1.8 中,如果 HashSet 中已经存在相同元素,底层 HashMap 会保留原有键,HashSet#add() 返回 false;不存在时才会新增元素并返回 true。
⭐️ HashMap 的底层实现
JDK1.8 之前
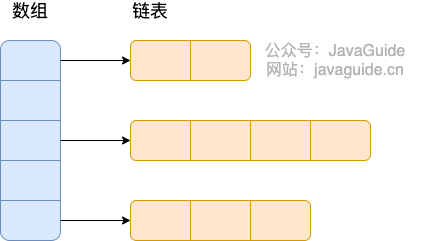
JDK1.8 之前 HashMap 底层是 数组和链表 结合在一起使用也就是 链表散列。HashMap 通过 key 的 hashcode 经过扰动函数处理过后得到 hash 值,然后通过 (n - 1) & hash 判断当前元素存放的位置(这里的 n 指的是数组的长度),如果当前位置存在元素的话,就判断该元素与要存入的元素的 hash 值以及 key 是否相同,如果相同的话,直接覆盖,不相同就通过拉链法解决冲突。
HashMap 中的扰动函数(hash 方法)是用来优化哈希值的分布。通过对原始的 hashCode() 进行额外处理,扰动函数可以减小由于糟糕的 hashCode() 实现导致的碰撞,从而提高数据的分布均匀性。
JDK 1.8 HashMap 的 hash 方法源码:
JDK 1.8 的 hash 方法 相比于 JDK 1.7 hash 方法更加简化,但是原理不变。
java
    static final int hash(Object key) {
      int h;
      // key.hashCode():返回散列值也就是hashcode
      // ^:按位异或
      // >>>:无符号右移,忽略符号位,空位都以0补齐
      return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}对比一下 JDK1.7 的 HashMap 的 hash 方法源码.
java
static int hash(int h) {
    // This function ensures that hashCodes that differ only by
    // constant multiples at each bit position have a bounded
    // number of collisions (approximately 8 at default load factor).

    h ^= (h >>> 20) ^ (h >>> 12);
    return h ^ (h >>> 7) ^ (h >>> 4);
}相比于 JDK1.8 的 hash 方法,JDK 1.7 的 hash 方法的性能会稍差一点点,因为毕竟扰动了 4 次。
所谓 “拉链法” 就是:将链表和数组相结合。也就是说创建一个链表数组,数组中每一格就是一个链表。若遇到哈希冲突,则将冲突的值加到链表中即可。
JDK1.8 之后
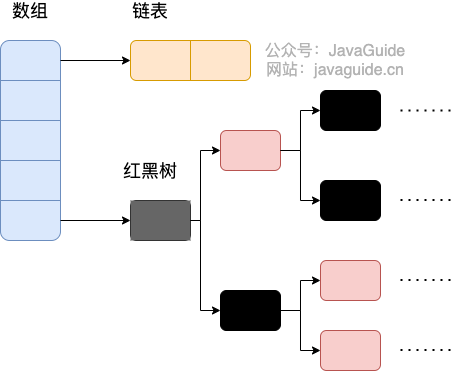
相比于之前的版本, JDK1.8 之后在解决哈希冲突时有了较大的变化,当链表长度大于阈值(默认为 8)(将链表转换成红黑树前会判断,如果当前数组的长度小于 64,那么会选择先进行数组扩容,而不是转换为红黑树)时,将链表转化为红黑树。
这样做的目的是减少搜索时间:链表的查询效率为 O(n)(n 是链表的长度),红黑树是一种自平衡二叉搜索树,其查询效率为 O(log n)。当链表较短时,O(n) 和 O(log n) 的性能差异不明显。但当链表变长时,查询性能会显著下降。
为什么优先扩容而非直接转为红黑树?
数组扩容能减少哈希冲突的发生概率(即将元素重新分散到新的、更大的数组中),这在多数情况下比直接转换为红黑树更高效。
红黑树需要保持自平衡,维护成本较高。并且,过早引入红黑树反而会增加复杂度。
为什么选择阈值 8 和 64?
- 泊松分布表明,链表长度达到 8 的概率极低(小于千万分之一)。在绝大多数情况下,链表长度都不会超过 8。阈值设置为 8,可以保证性能和空间效率的平衡。
- 数组长度阈值 64 同样是经过实践验证的经验值。在小数组中扩容成本低,优先扩容可以避免过早引入红黑树。数组大小达到 64 时,冲突概率较高,此时红黑树的性能优势开始显现。
TreeMap、TreeSet 以及 JDK1.8 之后的 HashMap 底层都用到了红黑树。红黑树就是为了解决二叉查找树的缺陷,因为二叉查找树在某些情况下会退化成一个线性结构。
我们来结合源码分析一下 HashMap 链表到红黑树的转换。
1、 putVal 方法中执行链表转红黑树的判断逻辑。
链表的长度大于 8 的时候,就执行 treeifyBin(转换红黑树)的逻辑。
java
// 遍历链表
for (int binCount = 0; ; ++binCount) {
    // 遍历到链表最后一个节点
    if ((e = p.next) == null) {
        p.next = newNode(hash, key, value, null);
        // 如果链表元素个数大于TREEIFY_THRESHOLD(8)
        if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st
            // 红黑树转换(并不会直接转换成红黑树)
            treeifyBin(tab, hash);
        break;
    }
    if (e.hash == hash &&
        ((k = e.key) == key || (key != null && key.equals(k))))
        break;
    p = e;
}2、treeifyBin 方法中判断是否真的转换为红黑树。
java
final void treeifyBin(Node<K,V>[] tab, int hash) {
    int n, index; Node<K,V> e;
    // 判断当前数组的长度是否小于 64
    if (tab == null || (n = tab.length) < MIN_TREEIFY_CAPACITY)
        // 如果当前数组的长度小于 64,那么会选择先进行数组扩容
        resize();
    else if ((e = tab[index = (n - 1) & hash]) != null) {
        // 否则才将列表转换为红黑树

        TreeNode<K,V> hd = null, tl = null;
        do {
            TreeNode<K,V> p = replacementTreeNode(e, null);
            if (tl == null)
                hd = p;
            else {
                p.prev = tl;
                tl.next = p;
            }
            tl = p;
        } while ((e = e.next) != null);
        if ((tab[index] = hd) != null)
            hd.treeify(tab);
    }
}将链表转换成红黑树前会判断,如果当前数组的长度小于 64,那么会选择先进行数组扩容,而不是转换为红黑树。
⭐️ HashMap 的长度为什么是 2 的幂次方
为了让 HashMap 存取高效并减少碰撞,我们需要确保数据尽量均匀分布。哈希值在 Java 中通常使用 int 表示,其范围是 -2147483648 ~ 2147483647 前后加起来大概 40 亿的映射空间,只要哈希函数映射得比较均匀松散,一般应用是很难出现碰撞的。但是,问题是一个 40 亿长度的数组,内存是放不下的。所以,这个散列值是不能直接拿来用的。用之前还要先做对数组的长度取模运算,得到的余数才能用来要存放的位置也就是对应的数组下标。
这个算法应该如何设计呢?
我们首先可能会想到采用 % 取余的操作来实现。对于非负的 hash,当 length 是 2 的幂次方时,hash % length 等价于 hash & (length - 1)。HashMap 使用后者计算数组下标。
除了上面所说的位运算比取余效率高之外,我觉得更重要的一个原因是:长度是 2 的幂次方,可以让 HashMap 在扩容的时候更均匀。例如:
- length = 8 时,length - 1 = 7 的二进制位
0111 - length = 16 时,length - 1 = 15 的二进制位
1111
这时候原本存在 HashMap 中的元素计算新的数组位置时 hash&(length-1),取决 hash 的第四个二进制位(从右数),会出现两种情况:
- 第四个二进制位为 0,数组位置不变,也就是说当前元素在新数组和旧数组的位置相同。
- 第四个二进制位为 1,数组位置在新数组扩容之后的那一部分。
这里列举一个例子:
plain
假设有一个元素的哈希值为 10101100

旧数组元素位置计算:
hash        = 10101100
length - 1  = 00000111
& -----------------
index       = 00000100  (4)

新数组元素位置计算:
hash        = 10101100
length - 1  = 00001111
& -----------------
index       = 00001100  (12)

看第四位(从右数):
1.高位为 0:位置不变。
2.高位为 1:移动到新位置(原索引位置+原容量)。⚠️注意:这里列举的场景看的是第四个二进制位,更准确点来说看的是高位(从右数),例如 length = 32 时,length - 1 = 31,二进制为 11111,这里看的就是第五个二进制位。
也就是说扩容之后,在旧数组元素 hash 值比较均匀(至于 hash 值均不均匀,取决于前面讲的对象的 hashcode() 方法和扰动函数)的情况下,新数组元素也会被分配的比较均匀,最好的情况是会有一半在新数组的前半部分,一半在新数组后半部分。
这样也使得扩容机制变得简单和高效,扩容后只需检查哈希值高位的变化来决定元素的新位置,要么位置不变(高位为 0),要么就是移动到新位置(高位为 1,原索引位置+原容量)。
最后,简单总结一下 HashMap 的长度是 2 的幂次方的原因:
- 位运算效率更高:位运算(&)比取余运算(%)更高效。对于非负的
hash,当长度为 2 的幂次方时,hash % length等价于hash & (length - 1)。 - 可以更好地保证哈希值的均匀分布:扩容之后,在旧数组元素 hash 值比较均匀的情况下,新数组元素也会被分配的比较均匀,最好的情况是会有一半在新数组的前半部分,一半在新数组后半部分。
- 扩容机制变得简单和高效:扩容后只需检查哈希值高位的变化来决定元素的新位置,要么位置不变(高位为 0),要么就是移动到新位置(高位为 1,原索引位置+原容量)。
⭐️ HashMap 多线程操作导致死循环问题
JDK1.7 及之前版本的 HashMap 在多线程环境下扩容操作可能存在死循环问题,这是由于当一个桶位中有多个元素需要进行扩容时,多个线程同时对链表进行操作,头插法可能会导致链表中的节点指向错误的位置,从而形成一个环形链表,进而使得查询元素的操作陷入死循环无法结束。
为了解决这个问题,JDK1.8 版本的 HashMap 采用了尾插法而不是头插法来避免链表倒置,使得插入的节点永远都是放在链表的末尾,避免了链表中的环形结构。但是还是不建议在多线程下使用 HashMap,因为多线程下使用 HashMap 还是会存在数据覆盖的问题。并发环境下,推荐使用 ConcurrentHashMap。
一般面试中这样介绍就差不多,不需要记各种细节,个人觉得也没必要记。如果想要详细了解 HashMap 扩容导致死循环问题,可以看看耗子叔的这篇文章:Java HashMap 的死循环。
⭐️ HashMap 为什么线程不安全?
HashMap 不是线程安全的。在多线程环境下对 HashMap 进行并发写操作,可能会导致两种主要问题:
- 数据丢失:并发
put操作可能导致一个线程的写入被另一个线程覆盖。 - 无限循环:在 JDK 7 及以前的版本中,并发扩容时,由于头插法可能导致链表形成环,从而在
get操作时引发无限循环,CPU 飙升至 100%。
数据丢失这个在 JDK1.7 和 JDK 1.8 中都存在,这里以 JDK 1.8 为例进行介绍。
JDK 1.8 后,在 HashMap 中,多个键值对可能会被分配到同一个桶(bucket),并以链表或红黑树的形式存储。多个线程对 HashMap 的 put 操作会导致线程不安全,具体来说会有数据覆盖的风险。
举个例子:
- 两个线程 1,2 同时进行 put 操作,并且发生了哈希冲突(hash 函数计算出的插入下标是相同的)。
- 不同的线程可能在不同的时间片获得 CPU 执行的机会,当前线程 1 执行完哈希冲突判断后,由于时间片耗尽挂起。线程 2 先完成了插入操作。
- 随后,线程 1 获得时间片,由于之前已经进行过 hash 碰撞的判断,所以此时会直接进行插入,这就导致线程 2 插入的数据被线程 1 覆盖了。
java
public V put(K key, V value) {
    return putVal(hash(key), key, value, false, true);
}

final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
                   boolean evict) {
    // ...
    // 判断是否出现 hash 碰撞
    // (n - 1) & hash 确定元素存放在哪个桶中,桶为空,新生成结点放入桶中(此时,这个结点是放在数组中)
    if ((p = tab[i = (n - 1) & hash]) == null)
        tab[i] = newNode(hash, key, value, null);
    // 桶中已经存在元素(处理hash冲突)
    else {
    // ...
}还有一种情况是这两个线程同时 put 操作导致 size 的值不正确:
- 线程 1 执行
if(++size > threshold)判断时,假设获得size的值为 10,由于时间片耗尽挂起。 - 线程 2 也执行
if(++size > threshold)判断,获得size的值也为 10,并将元素插入到该桶位中,并将size的值更新为 11。 - 随后,线程 1 获得时间片,它也将元素放入桶位中,并将 size 的值更新为 11。
- 线程 1、2 都执行了一次
put操作,但是size的值只增加了 1。此时计数发生了丢失更新,但不能仅根据size的结果判断实际插入了几个元素。
java
public V put(K key, V value) {
    return putVal(hash(key), key, value, false, true);
}

final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
                   boolean evict) {
    // ...
    // 实际大小大于阈值则扩容
    if (++size > threshold)
        resize();
    // 插入后回调
    afterNodeInsertion(evict);
    return null;
}HashMap 常见的遍历方式?
🐛 修正(参见:issue#1411):
这篇文章对于 parallelStream 遍历方式的性能分析有误,先说结论:存在阻塞时 parallelStream 性能最高, 非阻塞时 parallelStream 性能最低。
当遍历不存在阻塞时, parallelStream 的性能是最低的:
plain
Benchmark               Mode  Cnt     Score      Error  Units
Test.entrySet           avgt    5   288.651 ±   10.536  ns/op
Test.keySet             avgt    5   584.594 ±   21.431  ns/op
Test.lambda             avgt    5   221.791 ±   10.198  ns/op
Test.parallelStream avgt 5 6919.163 ± 1116.139 ns/op加入阻塞代码 Thread.sleep(10) 后, parallelStream 的性能才是最高的:
plain
Benchmark               Mode  Cnt           Score          Error  Units
Test.entrySet           avgt    5  1554828440.000 ± 23657748.653  ns/op
Test.keySet             avgt    5  1550612500.000 ±  6474562.858  ns/op
Test.lambda             avgt    5  1551065180.000 ± 19164407.426  ns/op
Test.parallelStream avgt 5 186345456.667 ± 3210435.590 ns/op⭐️ ConcurrentHashMap 和 Hashtable 的区别
ConcurrentHashMap 和 Hashtable 的区别主要体现在实现线程安全的方式上不同。
- 底层数据结构: JDK1.7 的
ConcurrentHashMap底层采用 分段的数组+链表 实现,在 JDK1.8 中采用的数据结构跟HashMap的结构一样,数组+链表/红黑二叉树。Hashtable和 JDK1.8 之前的HashMap的底层数据结构类似都是采用 数组+链表 的形式,数组是 HashMap 的主体,链表则是主要为了解决哈希冲突而存在的; - 实现线程安全的方式(重要):
- 在 JDK1.7 的时候,
ConcurrentHashMap对整个桶数组进行了分割分段(Segment,分段锁),每一把锁只锁容器其中一部分数据(下面有示意图),多线程访问容器里不同数据段的数据,就不会存在锁竞争,提高并发访问率。 - 到了 JDK1.8 的时候,
ConcurrentHashMap已经摒弃了Segment的概念,而是直接用Node数组+链表+红黑树的数据结构来实现,并发控制使用synchronized和 CAS 来操作。(JDK1.6 以后synchronized锁做了很多优化) 整个看起来就像是优化过且线程安全的HashMap,虽然在 JDK1.8 中还能看到Segment的数据结构,但是已经简化了属性,只是为了兼容旧版本; Hashtable(同一把锁) :使用synchronized来保证线程安全,效率非常低下。当一个线程访问同步方法时,其他线程也访问同步方法,可能会进入阻塞或轮询状态,如使用 put 添加元素,另一个线程不能使用 put 添加元素,也不能使用 get,竞争会越来越激烈效率越低。
- 在 JDK1.7 的时候,
下面,我们再来看看两者底层数据结构的对比图。
Hashtable :
https://www.cnblogs.com/chengxiao/p/6842045.html>
JDK1.7 的 ConcurrentHashMap:
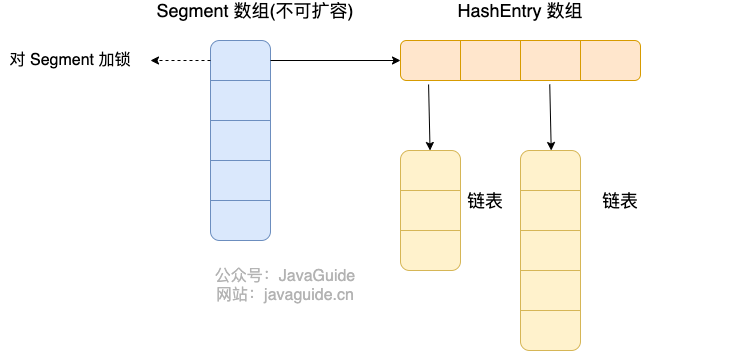
ConcurrentHashMap 是由 Segment 数组结构和 HashEntry 数组结构组成。
Segment 数组中的每个元素包含一个 HashEntry 数组,每个 HashEntry 数组属于链表结构。
JDK1.8 的 ConcurrentHashMap:
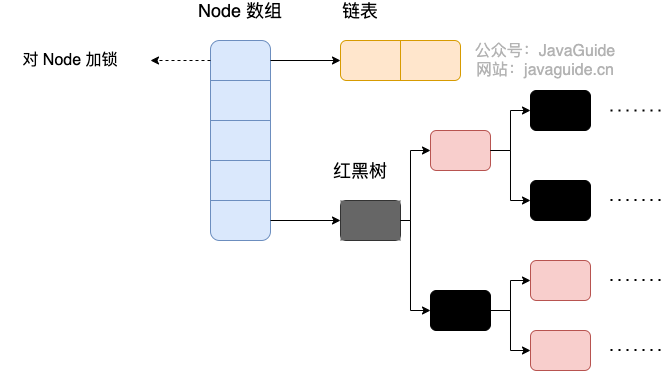
JDK1.8 的 ConcurrentHashMap 不再是 Segment 数组 + HashEntry 数组 + 链表,而是 Node 数组 + 链表 / 红黑树。不过,Node 只能用于链表的情况,红黑树的情况需要使用 **TreeNode**。当冲突链表达到一定长度时,链表会转换成红黑树。
TreeNode 是存储红黑树节点,被 TreeBin 包装。TreeBin 通过 root 属性维护红黑树的根结点,因为红黑树在旋转的时候,根结点可能会被它原来的子节点替换掉,在这个时间点,如果有其他线程要写这棵红黑树就会发生线程不安全问题,所以在 ConcurrentHashMap 中 TreeBin 通过 waiter 属性维护当前使用这棵红黑树的线程,来防止其他线程的进入。
java
static final class TreeBin<K,V> extends Node<K,V> {
        TreeNode<K,V> root;
        volatile TreeNode<K,V> first;
        volatile Thread waiter;
        volatile int lockState;
        // values for lockState
        static final int WRITER = 1; // set while holding write lock
        static final int WAITER = 2; // set when waiting for write lock
        static final int READER = 4; // increment value for setting read lock
...
}⭐️ ConcurrentHashMap 线程安全的具体实现方式/底层具体实现
JDK1.8 之前
首先将数据分为一段一段(这个“段”就是 Segment)的存储,然后给每一段数据配一把锁,当一个线程占用锁访问其中一个段数据时,其他段的数据也能被其他线程访问。
ConcurrentHashMap 是由 Segment 数组结构和 HashEntry 数组结构组成。
Segment 继承了 ReentrantLock,所以 Segment 是一种可重入锁,扮演锁的角色。HashEntry 用于存储键值对数据。
java
static class Segment<K,V> extends ReentrantLock implements Serializable {
}一个 ConcurrentHashMap 里包含一个 Segment 数组,Segment 的个数一旦初始化就不能改变。 Segment 数组的大小默认是 16,也就是说默认可以同时支持 16 个线程并发写。
Segment 的结构和 HashMap 类似,是一种数组和链表结构,一个 Segment 包含一个 HashEntry 数组,每个 HashEntry 是一个链表结构的元素,每个 Segment 守护着一个 HashEntry 数组里的元素,当对 HashEntry 数组的数据进行修改时,必须首先获得对应的 Segment 的锁。也就是说,对同一 Segment 的并发写入会被阻塞,不同 Segment 的写入是可以并发执行的。
JDK1.8 之后
Java 8 几乎完全重写了 ConcurrentHashMap,代码量从原来 Java 7 中的 1000 多行,变成了现在的 6000 多行。
ConcurrentHashMap 取消了 Segment 分段锁,采用 Node + CAS + synchronized 来保证并发安全。数据结构跟 HashMap 1.8 的结构类似,数组+链表/红黑二叉树。Java 8 在链表长度超过一定阈值(8)时将链表(寻址时间复杂度为 O(N))转换为红黑树(寻址时间复杂度为 O(log(N)))。
Java 8 中,锁粒度更细,更新非空桶时通常使用 synchronized 锁定桶的首节点,不同桶上的更新通常可以并行执行,读取操作也不会使用这些桶锁。
⭐️ JDK 1.7 和 JDK 1.8 的 ConcurrentHashMap 实现有什么不同?
- 线程安全实现方式:JDK 1.7 采用
Segment分段锁来保证安全,Segment是继承自ReentrantLock。JDK1.8 放弃了Segment分段锁的设计,采用Node + CAS + synchronized保证线程安全,锁粒度更细,synchronized只锁定当前链表或红黑二叉树的首节点。 - Hash 碰撞解决方法 : JDK 1.7 采用拉链法,JDK1.8 采用拉链法结合红黑树(链表长度超过一定阈值时,将链表转换为红黑树)。
- 并发度:JDK 1.7 并发更新主要受
Segment数量限制,默认是 16。JDK 1.8 不再使用固定数量的Segment,不同桶上的更新通常可以并行执行。
ConcurrentHashMap 为什么 key 和 value 不能为 null?
ConcurrentHashMap 的 key 和 value 不能为 null 主要是为了避免二义性。null 是一个特殊的值,表示没有对象或没有引用。如果你用 null 作为键,那么你就无法区分这个键是否存在于 ConcurrentHashMap 中,还是根本没有这个键。同样,如果你用 null 作为值,那么你就无法区分这个值是否是真正存储在 ConcurrentHashMap 中的,还是因为找不到对应的键而返回的。
拿 get 方法取值来说,返回的结果为 null 存在两种情况:
- 值没有在集合中;
- 值本身就是 null。
这也就是二义性的由来。
具体可以参考 ConcurrentHashMap 源码分析。
多线程环境下,存在一个线程操作该 ConcurrentHashMap 时,其他的线程将该 ConcurrentHashMap 修改的情况,所以无法通过 containsKey(key) 来判断否存在这个键值对,也就没办法解决二义性问题了。
与此形成对比的是,HashMap 可以存储 null 的 key 和 value,但 null 作为键只能有一个,null 作为值可以有多个。如果传入 null 作为参数,就会返回 hash 值为 0 的位置的值。单线程环境下,不存在一个线程操作该 HashMap 时,其他的线程将该 HashMap 修改的情况,所以可以通过 containsKey(key) 来判断是否存在这个键值对,从而做相应的处理,也就不存在二义性问题。
也就是说,多线程下无法正确判定键值对是否存在(存在其他线程修改的情况),单线程是可以的(不存在其他线程修改的情况)。
如果你确实需要在 ConcurrentHashMap 中使用 null 的话,可以使用一个特殊的静态空对象来代替 null。
java
public static final Object NULL = new Object();最后,再分享一下 ConcurrentHashMap 作者本人 (Doug Lea)对于这个问题的回答:
The main reason that nulls aren't allowed in ConcurrentMaps (ConcurrentHashMaps, ConcurrentSkipListMaps) is that ambiguities that may be just barely tolerable in non-concurrent maps can't be accommodated. The main one is that if
map.get(key)returnsnull, you can't detect whether the key explicitly maps tonullvs the key isn't mapped. In a non-concurrent map, you can check this viamap.contains(key), but in a concurrent one, the map might have changed between calls.
翻译过来之后的,大致意思还是单线程下可以容忍歧义,而多线程下无法容忍。
⭐️ ConcurrentHashMap 能保证复合操作的原子性吗?
ConcurrentHashMap 是线程安全的,意味着它可以保证多个线程同时对它进行读写操作时,不会出现数据不一致的情况,也不会导致 JDK1.7 及之前版本的 HashMap 多线程操作导致死循环问题。但是,这并不意味着它可以保证所有的复合操作都是原子性的,一定不要搞混了!
复合操作是指由多个基本操作(如 put、get、remove、containsKey 等)组成的操作,例如先判断某个键是否存在 containsKey(key),然后根据结果进行插入或更新 put(key, value)。这种操作在执行过程中可能会被其他线程打断,导致结果不符合预期。
例如,有两个线程 A 和 B 同时对 ConcurrentHashMap 进行复合操作,如下:
java
// 线程 A
if (!map.containsKey(key)) {
map.put(key, value);
}
// 线程 B
if (!map.containsKey(key)) {
map.put(key, anotherValue);
}如果线程 A 和 B 的执行顺序是这样:
- 线程 A 判断 map 中不存在 key
- 线程 B 判断 map 中不存在 key
- 线程 B 将 (key, anotherValue) 插入 map
- 线程 A 将 (key, value) 插入 map
那么最终的结果是 (key, value),而不是预期的 (key, anotherValue)。这就是复合操作的非原子性导致的问题。
那如何保证 ConcurrentHashMap 复合操作的原子性呢?
ConcurrentHashMap 提供了一些原子性的复合操作,如 putIfAbsent、compute、computeIfAbsent、computeIfPresent、merge 等。这些方法都可以接受一个函数作为参数,根据给定的 key 和 value 来计算一个新的 value,并且将其更新到 map 中。
上面的代码可以改写为:
java
// 线程 A
map.putIfAbsent(key, value);
// 线程 B
map.putIfAbsent(key, anotherValue);或者:
java
// 线程 A
map.computeIfAbsent(key, k -> value);
// 线程 B
map.computeIfAbsent(key, k -> anotherValue);很多同学可能会说了,这种情况也能加锁同步呀!确实可以,但不建议使用加锁的同步机制,违背了使用 ConcurrentHashMap 的初衷。在使用 ConcurrentHashMap 的时候,尽量使用这些原子性的复合操作方法来保证原子性。
Collections 工具类(不重要)
Collections 工具类常用方法:
- 排序
- 查找,替换操作
- 同步控制(不推荐,需要线程安全的集合类型时请考虑使用 JUC 包下的并发集合)
排序操作
java
void reverse(List list)//反转
void shuffle(List list)//随机排序
void sort(List list)//按自然排序的升序排序
void sort(List list, Comparator c)//定制排序,由Comparator控制排序逻辑
void swap(List list, int i , int j)//交换两个索引位置的元素
void rotate(List list, int distance)//旋转。当distance为正数时,将list后distance个元素整体移到前面。当distance为负数时,将 list的前distance个元素整体移到后面查找,替换操作
java
int binarySearch(List list, Object key)//对List进行二分查找,返回索引,注意List必须是有序的
int max(Collection coll)//根据元素的自然顺序,返回最大的元素。 类比int min(Collection coll)
int max(Collection coll, Comparator c)//根据定制排序,返回最大元素,排序规则由Comparatator类控制。类比int min(Collection coll, Comparator c)
void fill(List list, Object obj)//用指定的元素代替指定list中的所有元素
int frequency(Collection c, Object o)//统计元素出现次数
int indexOfSubList(List list, List target)//统计target在list中第一次出现的索引,找不到则返回-1,类比int lastIndexOfSubList(List source, list target)
boolean replaceAll(List list, Object oldVal, Object newVal)//用新元素替换旧元素同步控制
Collections 提供了多个 synchronizedXxx() 方法·,该方法可以将指定集合包装成线程同步的集合,从而解决多线程并发访问集合时的线程安全问题。
所有访问都应当通过返回的包装器进行;使用 Iterator、Spliterator 或 Stream 遍历时,还需要手动同步该包装器。
我们知道 HashSet,TreeSet,ArrayList,LinkedList,HashMap,TreeMap 都是线程不安全的。Collections 提供了多个静态方法可以把他们包装成线程同步的集合。
最好不要用下面这些方法,效率非常低,需要线程安全的集合类型时请考虑使用 JUC 包下的并发集合。
方法如下:
java
synchronizedCollection(Collection<T>  c) //返回指定 collection 支持的同步(线程安全的)collection。
synchronizedList(List<T> list)//返回指定列表支持的同步(线程安全的)List。
synchronizedMap(Map<K,V> m) //返回由指定映射支持的同步(线程安全的)Map。
synchronizedSet(Set<T> s) //返回指定 set 支持的同步(线程安全的)set。